

Demandez à un agent de code d’« ajouter l’envoi de webhooks » et il commence à écrire du code en quelques secondes. Il ne s’arrête pas pour demander ce qui se passe quand une livraison échoue, combien de fois il faut réessayer, ou ce que le destinataire doit faire quand le même événement arrive deux fois. Ces décisions ne disparaissent pas. L’agent les prend en silence, dans un fichier que vous lirez trois jours plus tard, si vous le lisez.
Le 22 octobre 2026, Google a publié en open source un plugin construit autour de ce problème précis. Il s’appelle Elephant-Goldfish Model (EGM), et sa devise tient sur un post-it : concevoir avec un éléphant, relire avec un poisson rouge. Le dépôt a dépassé les 13 000 étoiles en deux semaines environ, et Google affirme que des milliers de ses ingénieurs l’utilisent chaque jour pour livrer du code en production.
J’ai passé la semaine à lire le dépôt : les fichiers de skills, les personas de relecteurs, les notes de tests et les issues ouvertes. Je n’ai pas encore utilisé EGM sur un vrai projet. Cet article est donc une analyse de ce qu’est le plugin et de la façon dont il est construit, pas un retour terrain. Quand je donne mon avis, je le signale.
L’article est organisé en trois couches :
L’annonce sur le blog Google Open Source résume le problème en trois mots : slop, bugs et effondrement du contexte. Les agents produisent du code plus vite qu’une équipe ne peut le lire. Le goulot d’étranglement est passé de l’écriture à la compréhension, et l’endroit le moins coûteux pour attraper un malentendu, c’est avant qu’une seule ligne existe.
Quiconque a travaillé avec Claude Code, Codex ou Copilot en mode agent connaît le scénario. Vous discutez une heure avec l’agent. Il a « compris » la fonctionnalité. Vous lui demandez d’écrire le plan, et le plan paraît complet. Il paraît complet pour l’agent, parce que l’agent le relit avec toute la conversation encore en mémoire. Chaque trou du document est comblé en silence par un contexte qui n’existe que dans cette session.
Puis la session se termine, ou la fenêtre de contexte se compacte, ou un collègue reprend le plan. Les trous deviennent des bugs.
EGM est la version packagée d’une idée de Dave Rensin, publiée en 2026 sous le titre Elephants, Goldfish and the New Golden Age of Software Engineering. L’essai défend trois idées :
C’est le deuxième point qui nous intéresse. Le test du poisson rouge est une façon simple et brutale de vérifier qu’un document tient debout tout seul. Rensin le faisait à la main. Le plugin EGM l’automatise, le structure et refuse de tricher.
Le document d’architecture d’EGM donne la raison sans détour : quand le même modèle relit son propre travail dans le même contexte, il a tendance à valider ses propres hypothèses erronées au lieu de trouver les erreurs. Un modèle qui garde le contexte en mémoire suppose que ce contexte est évident à la lecture du texte. Un relecteur qui n’a jamais vu la conversation ne peut pas faire cette supposition.
Ce n’est pas nouveau en génie logiciel. C’est la vieille règle selon laquelle l’auteur ne doit pas être le seul relecteur, appliquée aux agents. Ce qu’EGM ajoute, c’est la discipline : le plugin arrête la revue si votre environnement ne sait pas créer un sous-agent vraiment neuf. Une revue dans le même contexte, dit le skill, n’est pas une revue de poisson rouge.
EGM est un plugin open source composé de skills d’agent, de personas de relecteurs et de standards de documentation. Ce n’est pas un nouveau modèle. Il n’y a pas de poids. Il tourne dans l’agent de code que vous utilisez déjà et le guide à travers un workflow structuré, avec des prompts et des sous-agents.
Quelques faits à connaître avant de l’installer :
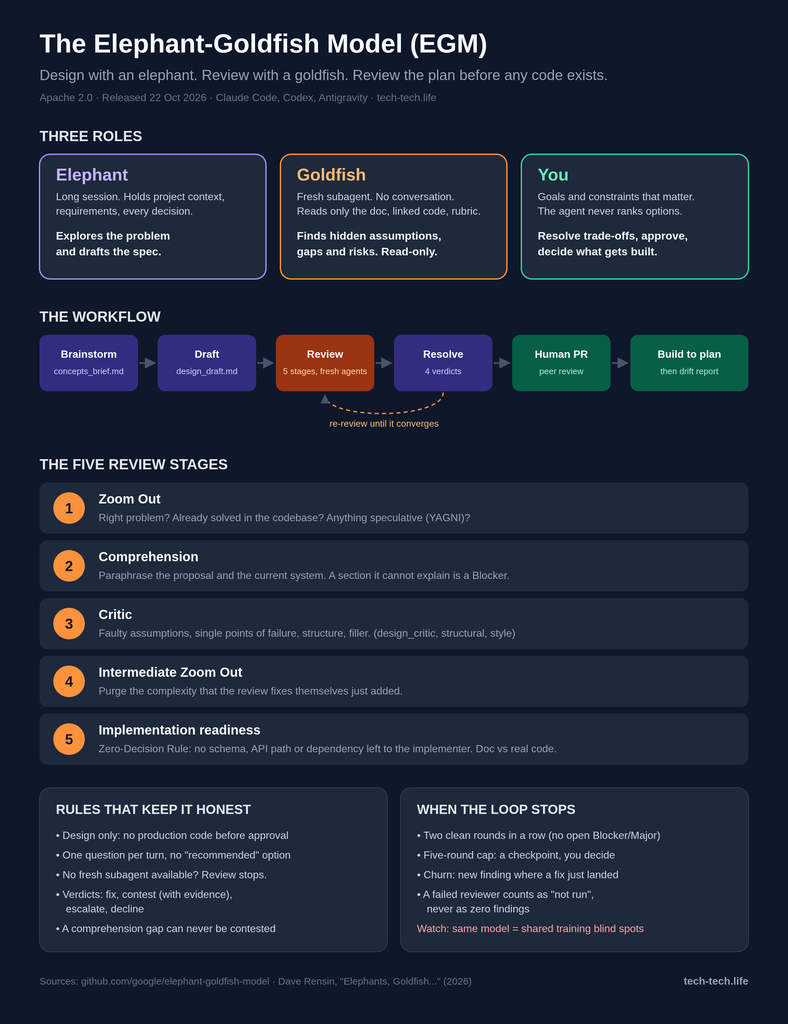
| Rôle | Ce qu’il sait | Ce qu’il fait |
|---|---|---|
| Éléphant | Votre projet, vos exigences, chaque décision prise plus tôt dans la conversation | Explore le problème avec vous et rédige la spécification |
| Poisson rouge | Seulement le document, les fichiers qu’il référence, la grille de revue et une éventuelle liste de lecture que vous fournissez | Repère les hypothèses implicites, les exigences floues et les risques d’implémentation |
| Vous | Les objectifs et contraintes qui comptent vraiment | Tranchez les compromis, approuvez la conception, décidez de ce qui sera construit |
Deux détails passent facilement inaperçus. D’abord, « zéro contexte » veut dire aucune conversation antérieure, pas aucune information : le poisson rouge lit quand même le code référencé par le document. Ensuite, le rôle humain n’est pas décoratif. Le skill de rédaction interdit à l’agent de classer les options d’architecture ou d’en marquer une par défaut. C’est vous qui choisissez.
Rien n’oblige à suivre toute la séquence. Chaque skill s’utilise seul.
| Skill | Rôle | Livrable principal |
|---|---|---|
egm-brainstorm | Explorer une idée, répondre aux questions ouvertes une par une, puis la faire challenger en parallèle par six relecteurs aux angles différents | concepts_brief.md |
egm-draft | Transformer le brief (ou des notes existantes) en document de conception, section par section, avec votre validation à chaque étape | design_draft.md, puis docs/designs/<feature>.md |
egm-review | Relire la conception avec des sous-agents neufs, en cinq étapes | Un rapport par étape |
egm-review-loop | Faire tourner un groupe de relecteurs configuré, par tours, jusqu’à convergence | goldfish_review_report.md à chaque tour |
egm-resolve | Traiter les remarques et s’accorder sur les modifications | Rapport annoté et modifications |
egm-bootstrap | Générer des « contrats » README par répertoire pour une base de code existante | Fichiers README.md décrivant invariants, interfaces, effets de bord |
egm-drift-report | Comparer les documents de conception versionnés avec le code actuel | {date}_DRIFT_REPORT.md |
Chaque skill est déclenché par l’utilisateur. Sur Claude Code, ils sont configurés pour que le modèle ne puisse pas les lancer de lui-même. C’est vous qui démarrez le workflow.
Conception uniquement, pas de code de production. Pendant la conception, l’agent n’a pas le droit de toucher à l’implémentation. Il peut écrire des exemples de code clairement identifiés dans le Markdown, une esquisse d’interface par exemple, mais la modification réelle attend l’approbation du design. Le document d’architecture explique pourquoi : par défaut, les agents de code se mettent à écrire du code immédiatement, dans les fichiers voisins.
Une question par tour. Pendant le brainstorming et la rédaction, l’éléphant vous pose une seule question à la fois et ne marque aucune réponse comme « recommandée ». C’est plus lent qu’un mur d’options. Ça vous oblige aussi à décider au lieu de valider machinalement.
C’est le cœur du plugin. egm-review commence par couper le document au titre ## Detailed Implementation Plan en une partie fonctionnelle (quoi et pourquoi) et une partie détaillée (comment). Puis il enchaîne cinq étapes dans l’ordre. Au sein d’une étape, les relecteurs travaillent en parallèle.
| # | Étape | Relecteurs | Question posée |
|---|---|---|---|
| 1 | Zoom Out | zoom_out | Est-ce le bon problème ? Quelque chose dans le code le résout-il déjà ? Y a-t-il du spéculatif (YAGNI) ? |
| 2 | Compréhension | comprehension | Un lecteur neuf peut-il reformuler la proposition et le système existant qu’elle décrit ? |
| 3 | Critique | design_critic, structural, style | Hypothèses fausses, points de défaillance uniques, structure bancale, remplissage et affirmations subjectives |
| 4 | Zoom Out intermédiaire | zoom_out | Les corrections de l’étape 3 ont-elles ajouté de la complexité inutile ? |
| 5 | Prêt pour l’implémentation | implementation_readiness, codebase_details, style | Le plan laisse-t-il une décision à celui qui implémente ? Contredit-il le code réel ? |
(Dans le skill, ces étapes sont numérotées de 5 à 9, après quatre étapes de préparation. Je les numérote de 1 à 5 ici pour la lisibilité.)
Trois choix méritent qu’on s’y arrête.
Le Zoom Out passe deux fois. Le premier passage vérifie le cadrage avant d’investir dans le détail. Le second existe parce que les corrections de revue ont tendance à ajouter des choses : un cache par-ci, un paramètre de configuration par-là. L’étape 4 sert à éliminer la complexité spéculative introduite par la revue elle-même. J’ai vu des revues de conception humaines faire exactement cette erreur pendant vingt ans.
La compréhension commence par une reformulation. Le relecteur de compréhension doit reformuler, avec ses propres mots, la proposition et la description que le document donne du système actuel. Le fichier de persona explique pourquoi : une liste de termes non définis ne détecte pas un document dont tous les termes sont définis mais dont les parties ne s’emboîtent pas. Si la reformulation ne correspond pas à ce que vous vouliez dire, il manque un lien dans le document. Et une section que le relecteur ne sait pas expliquer est un point bloquant.
Les standards sont exigeants. Le standard de spécification fonctionnelle contient une règle des alternatives : une spec qui propose une seule voie sans documenter les alternatives écartées échoue. Le standard de préparation à l’implémentation contient une règle zéro décision : un plan qui laisse l’implémenteur choisir un schéma, un chemin d’API ou une dépendance échoue. Cette deuxième règle est, à mon sens, l’idée la plus utile du dépôt. C’est une définition précise de « prêt à confier à un agent ».
Quatre modes sont proposés : toutes les étapes avec un point d’arrêt après chacune, un rapport consolidé d’une traite, les étapes fonctionnelles seulement, ou la seule étape de préparation à l’implémentation.
Sept personas de relecteurs, plus deux assistants. Tous les relecteurs partagent le même préambule : lecture seule stricte, aucun historique de conversation.
| Persona | Focus |
|---|---|
zoom_out | Cadrage du problème, réutilisation de l’existant, YAGNI |
comprehension | Reformulation d’abord, puis termes projet non définis |
design_critic | Hypothèses erronées, points de défaillance uniques |
structural | Titres, hiérarchie, liens |
style | Remplissage, affirmations vagues ou subjectives |
implementation_readiness | Décisions encore ouvertes dans le plan |
codebase_details | Le document confronté au code réel ; une contradiction est bloquante |
synthesizer (assistant) | Lance les relecteurs, dédoublonne, trie par Bloquant, Majeur, Mineur |
bootstrap_orchestrator (assistant) | Découpe une arborescence de code pour la documentation par répertoire |
Le synthétiseur existe pour une raison pratique : déverser neuf rapports directement dans la session principale saturerait la fenêtre de contexte de l’éléphant. La compréhension fait exception. Son rapport vous parvient directement, parce que c’est la reformulation elle-même que vous devez lire, pas un résumé.
Quand les remarques reviennent, egm-resolve oblige l’éléphant à répondre à chacune par l’un de ces quatre verdicts :
Deux règles montrent une vraie réflexion. L’éléphant ne peut jamais contester un défaut de compréhension : si un lecteur neuf n’a pas pu suivre le document, c’est qu’il manque du contexte, point. Et le skill met l’éléphant en garde contre son propre biais, en rappelant qu’une envie de contester ne prouve pas que le relecteur a tort. Il précise aussi de ne pas ajouter de contexte uniquement pour satisfaire un relecteur : on ajoute ce dont un lecteur humain a besoin, on escalade ce dont seul un agent sans contexte a besoin.
Les relecteurs sont stochastiques. Un poisson rouge neuf lit le document différemment à chaque tour, donc viser « zéro remarque » n’a pas de sens. La boucle s’arrête dans l’un de ces cas :
Un relecteur qui échoue deux fois est enregistré comme « non exécuté », jamais comme « zéro remarque ». Cette petite règle empêche un échec silencieux de passer pour un certificat de bonne santé.
Installez le plugin complet : les skills lisent les prompts des relecteurs et les standards au moment de l’exécution.
Claude Code
claude plugin marketplace add google/elephant-goldfish-model
claude plugin install egm@egm
Codex CLI
codex plugin marketplace add google/elephant-goldfish-model
codex plugin add egm@egm
Antigravity CLI
agy plugin install https://github.com/google/elephant-goldfish-model
Ouvrez ensuite une nouvelle session. Dans Claude Code et Antigravity, les commandes prennent le préfixe /egm:, par exemple /egm:egm-brainstorm. Dans Codex, choisissez le skill dans le sélecteur. Le brainstorming et la revue nécessitent un environnement capable de créer des sous-agents neufs.
Le README prend l’envoi de webhooks comme premier exemple, et c’est un bon choix : facile à décrire, plein de décisions cachées. Voici à quoi ressemble le parcours. Les remarques ci-dessous sont illustratives, rédigées par moi pour montrer le type de retour de chaque étape, pas copiées d’une exécution réelle.
Étape 1. Brainstorm.
/egm:egm-brainstorm Add webhook delivery to this project.
L’éléphant pose une question à la fois. Qui enregistre les endpoints ? Signe-t-on les payloads ? Quelle politique de retry ? Que se passe-t-il après la dernière tentative ? Une fois l’hypothèse de travail validée, six relecteurs aux angles différents la challengent en parallèle, et la direction retenue est enregistrée dans concepts_brief.md.
Étape 2. Rédaction.
/egm:egm-draft
L’éléphant transforme le brief en design_draft.md, en s’arrêtant après chaque section. Arrivé à l’architecture, il présente des options, par exemple une table outbox en base de données ou une file de messages, sans les classer. Vous choisissez, et l’option écartée est consignée avec sa raison.
Étape 3. Revue.
/egm:egm-review design_draft.md
Le type de remarques à attendre :
jobs/. Pourquoi ajouter une nouvelle file ? »OrderService.complete(). Cette méthode n’existe plus, voir orders/service.py. »Étape 4. Résoudre, approuver, faire relire, construire. Vous traitez les remarques avec egm-resolve. Le guide de démarrage demande ensuite d’envoyer la conception approuvée à un autre humain, sous forme de pull request, avant l’implémentation. C’est seulement après que vous demandez à l’agent de construire selon le plan.
Plus tard : la dérive. Quelques mois après, egm-drift-report compare docs/designs/webhooks.md au code et vous indique où ils divergent. À vous de décider si c’est la doc ou le code qui change.
La plupart d’entre nous ne travaillent pas sur des projets neufs. egm-bootstrap traite ce cas en écrivant des contrats README.md par répertoire : invariants locaux, interfaces publiques, effets de bord. Le document de conception associé explique que, sans ce contexte, les agents font de mauvaises hypothèses sur le code existant. Sur une grosse base de code historique, ce pourrait être le skill le plus utile du paquet, indépendamment du workflow de conception. C’est aussi le seul sous-agent capable d’exécuter des commandes shell, donc vérifiez ses permissions avant de le lâcher sur quoi que ce soit de sensible.
J’aime ce plugin. Je trouve qu’il encode de bonnes habitudes d’ingénierie mieux que la plupart des frameworks que j’ai testés. C’est justement pour ça qu’il mérite un regard exigeant.
« Des milliers de Googlers l’utilisent chaque jour » est une affirmation sur l’usage. Elle ne dit rien des taux de défauts, du temps de revue ou de la vitesse de livraison, et le dépôt ne prétend pas le contraire. La FAQ du projet est honnête là-dessus : terminer le workflow EGM ne démontre pas, à lui seul, un gain de productivité. Aucun benchmark de qualité de conception n’est publié, et les scénarios de test qu’un document de conception présente comme un benchmark de précision et de rappel sont, à ce jour, des vérifications de format que rien n’exécute réellement.
Ce n’est pas une raison pour écarter EGM. C’est une raison de le mesurer vous-même avant de l’imposer.
Sur Claude Code, les relecteurs héritent du même modèle que l’éléphant. L’indépendance vient de la remise à zéro du contexte, de la grille de revue et de l’accès au code. Ça supprime le biais conversationnel, qui est le problème principal décrit par Rensin. Ça ne supprime pas le biais d’entraînement. Si le modèle a une croyance fausse sur le comportement d’une bibliothèque, l’éléphant et tous les poissons rouges peuvent la partager. L’annonce affirme que les poissons rouges ne partagent aucun angle mort avec le concepteur. C’est vrai pour l’historique de conversation. Ce n’est pas démontré pour les connaissances du modèle.
Ma suggestion, et c’est mon avis, pas quelque chose que documente EGM : pour les conceptions à fort enjeu, faites au moins un tour de revue avec une autre famille de modèles. Contexte neuf et diversité de modèles réunis, c’est une indépendance plus solide que l’un ou l’autre seul.
Les auteurs le disent clairement : il s’agit d’une isolation du contexte et des outils, pas du système de fichiers. Sur Claude Code, les relecteurs reçoivent une liste d’outils en lecture seule et peuvent ignorer CLAUDE.md, et c’est l’hôte qui l’impose. Sur d’autres environnements, la lecture seule repose sur le prompt qui le demande poliment. Une issue ouverte (#237) signale que sur Codex et Antigravity, des fichiers d’instructions comme AGENTS.md atteignent quand même les relecteurs. Une autre (#262) demande d’indiquer, environnement par environnement, ce qui est imposé par l’hôte et ce qui dépend seulement du prompt. Si votre modèle de menace inclut un relecteur qui modifie des fichiers, vérifiez votre environnement.
Une revue complète lance neuf sous-agents relecteurs. Les exécutions de test enregistrées qui incluent le brainstorming en ont lancé quinze ou seize. Les boucles de revue et les relances en ajoutent. Personne n’a publié le coût en tokens d’une revue typique, et le projet le reconnaît. Le guide de démarrage prévient aussi qu’EGM produit beaucoup de retours, par conception. Quelqu’un doit les trier. Ce quelqu’un, c’est vous.
La FAQ ajoute qu’un excès de documentation peut devenir un goulot d’étranglement, et le README conseille de se passer d’EGM pour un petit correctif clair. Prenez ce conseil au sérieux. Lancer cinq étapes de revue sur une modification d’une ligne, c’est du théâtre.
Tout ce qui garde le workflow honnête, la règle de conception seule, la règle d’une question par tour, l’ordre des étapes, vit dans du texte de prompt. Aucun contrôleur séparé ne l’impose. En pratique, ça marche parce que les modèles suivent bien les instructions. Mais un agent obstiné ou perdu peut dériver, et vous ne le verrez que si vous regardez. Une issue ouverte (#271) signale même que les propres documents de conception du projet ont dérivé par rapport aux skills livrés, ce qui est assez ironique pour un plugin qui fournit un rapport de dérive.
En juillet, j’ai comparé les principaux frameworks de code assisté par IA : Spec Kit, OpenSpec, Superpowers, BMAD Method et d’autres (à lire ici). La plupart répondent à la question comment amener l’agent à écrire une spec avant le code ? EGM répond à une autre question : comment savoir si la spec est assez bonne ?
Il est donc moins un concurrent qu’une couche manquante. On peut tout à fait imaginer une spécification Spec Kit passer par egm-review. Ce qu’EGM apporte et que je n’ai pas vu packagé aussi proprement ailleurs :
Le prix, comparé à des frameworks plus légers, c’est du temps, des tokens et de l’attention. C’est un outil lourd pour des décisions lourdes.
Utilisez-le quand une fonctionnalité contient des décisions qu’un agent prendrait à votre place : modèles de données, gestion des échecs, frontières de sécurité, API publiques, tout ce dont une autre équipe dépendra. Utilisez aussi egm-bootstrap et egm-drift-report sur du code existant, même si vous n’adoptez jamais le workflow complet.
Passez-vous-en pour les petites modifications bien comprises, les prototypes jetables, et les équipes qui n’écrivent encore aucun document de conception. Commencez alors par faire le test du poisson rouge à la main.
Si vous voulez tester EGM dans votre équipe, voici comment je m’y prendrais :
EGM n’a rien de magique, et Google ne prétend pas le contraire. C’est une version soigneusement construite d’une idée simple : celui qui a écrit le plan est le plus mal placé pour juger si le plan est clair. Le plugin transforme cette idée en skills, personas, standards et règles d’arrêt, et il refuse de faire semblant qu’une revue a eu lieu quand ce n’est pas le cas.
Le message de fond est celui de l’essai de Rensin. Quand les agents écrivent le code, le document de conception devient le vrai produit du travail d’ingénierie, et notre valeur se déplace vers les décisions qu’il contient. Un poisson rouge ne peut pas prendre ces décisions. Il peut seulement vous dire, très précisément, lesquelles vous avez oublié d’écrire.
Rien que pour ça, il mérite un après-midi de test.