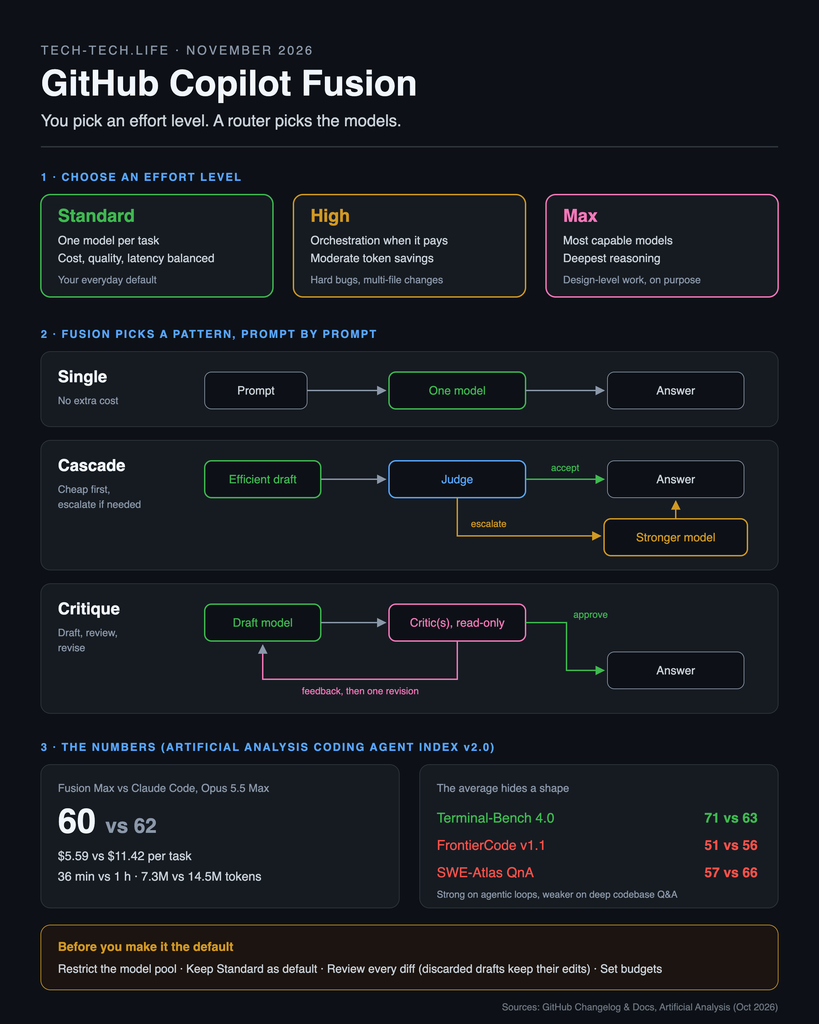


La version courte. Le 28 octobre 2026, lors de GitHub Universe, GitHub a rendu Copilot Fusion disponible pour tous. Dans le sélecteur de modèles, vous ne choisissez plus Claude, GPT ou Gemini. Vous choisissez “Copilot Fusion” et un niveau d’effort (Standard, High ou Max), et Copilot décide, prompt par prompt, quels modèles travaillent et comment ils coopèrent : un modèle seul, un modèle économique surveillé par un juge qui peut escalader, ou un brouillon relu par d’autres modèles. Sur l’Artificial Analysis Coding Agent Index, Fusion Max obtient 60, contre 62 pour Claude Code avec Opus 5.5 Max, pour environ la moitié du coût par tâche et environ 40 % de temps en moins. Pour moi, c’est le changement le plus important de Copilot cette année. Je pense aussi que la plupart des équipes vont mal lire le chiffre phare, et que les environnements régulés comme le mien ont des devoirs à faire avant de l’activer par défaut.
Regardez le sélecteur de modèles de Copilot aujourd’hui. GitHub y liste 28 modèles en disponibilité générale, dont 11 viennent d’Anthropic. Chacun a son prix, ses points forts et ses manières de se tromper. Demander à chaque développeur de choisir le bon modèle à chaque prompt a toujours été une fiction.
Dans la vraie vie, c’est plus simple et plus cher. Un développeur tombe sur un bug difficile, passe au plus gros modèle, corrige le bug, puis garde ce gros modèle pendant trois jours pour renommer des variables et écrire des docstrings. AT&T a décrit exactement ce comportement dans l’annonce de GitHub : on prend un modèle puissant pour une tâche complexe et on oublie de revenir en arrière. Selon eux, Fusion Standard a réduit ce gaspillage dans toute l’entreprise.
Les données de GitHub vont dans le même sens. D’après Octoverse 2026, 63 % des développeurs Copilot payants ont utilisé la sélection automatique de modèle au moins une fois en septembre. Les gens étaient déjà prêts à déléguer ce choix. Fusion part de cette habitude et y ajoute l’orchestration.
Il y a une deuxième raison, moins visible depuis l’IDE. La qualité du modèle n’est plus le seul facteur qui distingue les agents de code. Le harnais autour du modèle (outils, gestion du contexte, boucles de relecture, routage) fait aujourd’hui bouger les scores autant que le modèle lui-même. Devin et OpenRouter ont tous deux lancé leur propre forme de “fusion” multi-modèles cette année. GitHub possède le harnais, les intégrations dans les éditeurs et la relation de facturation : un routeur est la couche suivante logique.
Fusion n’est pas sorti de nulle part. La filiation est courte et publique :
| Date | Étape |
|---|---|
| Début 2026 | Sélection automatique de modèle : Copilot choisit un modèle par tâche |
| 4 septembre 2026 | Preview de recherche Project HydraFusion dans Copilot CLI (via /experimental) |
| 30 septembre 2026 | HydraFusion arrive dans VS Code et l’application Copilot |
| 28 octobre 2026 | Copilot Fusion en disponibilité générale, fusion de la sélection auto et de HydraFusion |
Si vous aviez activé auto, HydraFusion ou HydraFusion Max pendant la preview, GitHub vous bascule automatiquement vers le niveau Fusion correspondant.
Quand vous choisissez Fusion, le sélecteur ne contient plus un modèle. Il contient une politique de routage. Pour chaque requête, Fusion lit des signaux de capacité (raisonnement, génération de code, débogage, usage d’outils) et choisit un schéma d’exécution, un niveau de raisonnement et les modèles qui vont l’exécuter. GitHub décrit cette décision comme une étape légère qui ajoute très peu de latence.
Deux détails de la documentation comptent plus qu’il n’y paraît :
| Niveau | Ce que GitHub dit prioriser | Quand je l’utiliserais |
|---|---|---|
| Fusion Standard | Équilibre coût, qualité, latence. Un modèle par tâche. | Par défaut au quotidien : explications, petites modifications, tests, documentation |
| Fusion High | Orchestration avec économie de tokens modérée | Travail bien cadré mais conséquent : un bug coriace, un changement sur plusieurs fichiers |
| Fusion Max | Capacité de pointe, en surveillant quand même les tokens | Raisonnement difficile, refactoring de conception, la tâche que vous confieriez à votre meilleur senior |
| Fusion Fast | Réservé aux scénarios qui exigent des modèles rapides | Non sélectionnable. Utilisé dans le chat inline de VS Code |
La documentation publie une matrice par offre, et certaines analyses indépendantes indiquent que High et Max demandent une offre supérieure (Pro+ et au-delà). Vérifiez la matrice de votre offre avant de rédiger une consigne interne.
C’est le cœur de la fonctionnalité.
Single. Un seul modèle résout la tâche. C’est une requête normale.
Cascade. Un modèle efficace rédige une solution. Un juge examine le brouillon et l’accepte ou escalade vers un modèle plus fort. Vous payez le brouillon économique, le juge et, si besoin, le modèle fort.
Critique. Un modèle rédige, des relecteurs critiquent, le modèle d’origine révise. Dans la preview HydraFusion, il s’agissait d’un seul critique en lecture seule, issu d’une autre famille de modèles, avec une seule révision. La documentation actuelle décrit plusieurs critiques en parallèle, dont les retours sont agrégés avant la révision, alors que le changelog de lancement parle encore d’un seul relecteur. J’y vois un schéma qui évolue, et la documentation le dit explicitement : les schémas et le parc de modèles changeront.
Le schéma est choisi à chaque prompt. Votre premier prompt peut tourner en Single, la relance en Critique. Une tâche simple ne paie jamais une relecture inutile. Cascade et Critique prennent plus de temps puisqu’ils ajoutent des appels de modèles.
Vous suivez la progression de chaque étape et le modèle utilisé. Les brouillons intermédiaires restent masqués, car ils peuvent être révisés ou jetés ; vous ne recevez que la réponse finale. Ensuite, survoler le niveau d’effort affiche la liste des modèles utilisés.
Fusion n’a pas de fenêtre de contexte propre. Chaque étape tourne dans les limites du modèle qui l’exécute, et la fenêtre affichée pour Fusion est une valeur prudente basée sur le plus petit modèle du parc. Si vous collez souvent des fichiers énormes, gardez-le en tête.
GitHub a aussi lancé une preview expérimentale où Fusion peut router entre modèles locaux et modèles cloud, dans Copilot CLI, l’application Copilot et VS Code. Sur les machines Windows compatibles, vous pouvez télécharger MAI Code 1.1 Flash via Windows ML. Dans Copilot CLI, vous pouvez aussi brancher Qwen3.8 Flash Next via un serveur local compatible OpenAI (Ollama par exemple), sous Windows, macOS ou Linux. Les modèles locaux ne sont utilisés qu’au niveau Standard.
GitHub signale lui-même deux limites : les décisions de routage restent dans le cloud, donc votre session n’est pas hors ligne, et les modèles locaux n’ont pas forcément les mêmes protections de sécurité que les modèles cloud de Copilot. Un modèle ajouté en BYOK ne devient pas automatiquement éligible au routage Fusion.
Fusion n’a pas de tarif propre. Vous payez chaque modèle utilisé à son tarif standard, en crédits IA. Comme High et Max peuvent appeler plusieurs modèles pour une seule tâche, celle-ci peut consommer plus de crédits qu’en Standard. Jusqu’au 30 novembre 2026, les offres payantes bénéficient de 30 % de remise sur le coût des modèles avec Fusion.
Où l’utiliser aujourd’hui : VS Code, Copilot CLI, l’application GitHub Copilot et les IDE JetBrains, sur toutes les offres Copilot, avec d’autres clients annoncés.
Le message de lancement de GitHub : Fusion Max obtient 60 sur l’Artificial Analysis Coding Agent Index, à deux points de Claude Code avec Opus 5.5 Max, pour environ la moitié du coût API par tâche, avec environ moitié moins de tokens et environ 40 % de temps en moins. Artificial Analysis a publié le détail, et le détail est plus parlant que le titre.
| Artificial Analysis Coding Agent Index v2.0 | Claude Code, Opus 5.5 (Max) | Copilot Fusion (Max) |
|---|---|---|
| Indice global | 62 | 60 |
| FrontierCode v1.1 | 56 % | 51 % |
| Terminal-Bench 4.0 | 63 % | 71 % |
| SWE-Atlas QnA | 66 % | 57 % |
| Coût API moyen par tâche | 11,42 $ | 5,59 $ |
| Durée moyenne par tâche | 1,0 h | 36,1 min |
| Tokens par tâche | 14,5 M | 7,3 M |
Trois remarques.
La moyenne cache un profil. Fusion gagne nettement sur Terminal-Bench, qui mesure le travail agentique en plusieurs étapes dans un terminal. Il perd cinq points sur FrontierCode et neuf points sur SWE-Atlas QnA, qui porte sur la compréhension de vraies bases de code et les réponses aux questions qu’on se pose dessus. Un écart de deux points sur l’indice composite, c’est la somme d’une grosse victoire et de deux vraies défaites. Si vos développeurs enchaînent surtout des boucles agentiques “construire, tester, corriger”, Fusion est excellent. S’ils posent surtout des questions de fond sur un gros code legacy (coucou la banque), l’écart dépasse largement “deux points”.
Le coût par tâche est un prix catalogue. 5,59 $ contre 11,42 $, c’est un coût API au token sur un benchmark. Votre facture dépend de votre offre, de votre mix de tâches, du taux de cache, de la fréquence des escalades en Cascade et de la remise de lancement. Moitié prix sur un benchmark, c’est un signal fort, et une mauvaise prévision budgétaire.
Les premiers chiffres venaient de GitHub. Les résultats HydraFusion de septembre (TerminalBench 2.1 : +4,9 points pour 67 % de coût en moins ; DeepSWE : 1,5 point en dessous pour 36 % de coût en moins ; CheckpointBench : 0,1 point en dessous pour 65 % de coût en moins, le tout face à Opus 5) venaient d’évaluations hors ligne contrôlées, avec tous les modèles au niveau de raisonnement moyen, et CheckpointBench est un benchmark interne. GitHub l’a dit clairement. La mesure d’Artificial Analysis est le premier chiffre indépendant, sur une seule campagne et une seule version de l’indice.
Une autre ligne de cette comparaison mérite l’attention : la fusion maison de Devin, Opus 5.5 plus GPT-6 Luna, obtient 62 pour 8,00 $ par tâche. L’orchestration multi-modèles devient un standard de l’industrie. L’avantage de Copilot tient au prix et à l’intégration ; d’autres ont eu la même idée.
Il règle un vrai problème de comportement. La citation d’AT&T est la partie la plus honnête du lancement. Choisir son modèle est une discipline que personne ne tient. Un défaut qui s’adapte à chaque prompt vaut mieux qu’une note interne demandant aux développeurs de changer de modèle à la main.
La sélectivité est le bon choix de conception. L’idée intéressante de HydraFusion a toujours été d’utiliser le flux le plus simple qui atteint le niveau de qualité visé. Un prompt simple tourne sur un seul modèle et ne coûte rien de plus. C’est ainsi qu’un ingénieur senior délègue : on ne demande une seconde relecture que quand le changement le mérite.
La gestion du cache montre de la maturité. Les routeurs naïfs changent de modèle en pleine conversation et jettent le cache de prompt, ce qui peut effacer les économies promises. Router sur les frontières du cache, c’est le genre de détail peu glamour qui rend crédibles les promesses de coût.
La gouvernance est là dès le premier jour. Politiques de modèles, exclusions propres à Fusion, filtres de résidence des données et FedRAMP, défauts gérés. Pour une entreprise, cela compte plus que le benchmark.
Votre choix de modèle devient une politique fournisseur que vous ne contrôlez pas. Avec Fusion, le même prompt le mois prochain peut tourner sur d’autres modèles, avec un autre schéma, parce que GitHub a mis à jour le parc ou la politique de routage. Pour la productivité, pas de problème. Pour tout ce qui exige de la reproductibilité, c’est plus gênant : analyser une régression de comportement de l’agent, comparer deux sprints, ou expliquer à un auditeur pourquoi l’outil s’est comporté différemment en mars. Quand vous avez besoin d’un comportement stable, fixez un modèle.
La traçabilité est plus mince que ce qu’exige un environnement régulé. Survoler la réponse pour voir les modèles utilisés suffit à un développeur curieux. L’équipe risque de modèles ou conformité d’une banque posera une question plus dure : pour ce commit, quels modèles ont vu ce code, sous quelle politique, à quelle heure ? Avant de faire de Fusion un défaut, vérifiez ce que vos journaux d’audit, l’API d’usage et l’export OpenTelemetry enregistrent pour chaque requête. Je n’ai pas trouvé d’enregistrement de routage par requête documenté qui réponde seul à cette question. Si vous ne pouvez pas tracer, limitez le parc aux modèles déjà validés par votre équipe risque, pour que “quel modèle” cesse d’être une question de conformité.
Un brouillon jeté peut laisser des modifications derrière lui. Cette ligne des limites passe facilement inaperçue et je la mettrais en gras dans toute consigne interne : si Fusion jette un brouillon, les modifications faites par ce brouillon restent dans votre espace de travail. Mode agent plus Cascade ou Critique, cela veut dire relire le diff complet avant chaque commit. Ajoutez des hooks, des branches protégées et une relecture obligatoire, ce que vous devriez avoir de toute façon.
La latence se déplace là où vous la sentez. Cascade et Critique ajoutent des appels de modèles. Fusion Max a été plus rapide que Claude Code sur le benchmark, mais on compare deux agents lourds. Face à un modèle rapide sur une tâche de routine, un passage en High ou Max qui décide de lancer une critique paraîtra plus lent. Gardez Standard par défaut et laissez les gens monter d’un cran.
Les coûts deviennent moins prévisibles, au moins au début. Facturer chaque modèle utilisé est juste, et la documentation prévient que High et Max peuvent consommer plus de crédits que Standard. Mais une équipe finance habituée à une ligne par siège verra désormais une dépense variable pilotée par les décisions d’un routeur. Fixez budgets et plafonds de crédits avant le déploiement, et remesurez après le 30 novembre, à la fin de la remise.
La question du courtier. GitHub compare Fusion à Claude Code alors qu’Anthropic fournit 11 des 28 modèles de Copilot, dont l’Opus 5.5 utilisé comme référence. Fusion fait de GitHub un courtier entre fournisseurs de modèles. C’est pratique pour vous, et cela déplace le pouvoir de négociation vers GitHub. À terme, c’est le routeur qui décide quel fournisseur reçoit vos tokens. Bon à savoir avant de renégocier votre prochain contrat entreprise.
Les développeurs risquent de perdre le “toucher” des modèles. Si le routeur choisit toujours, les juniors n’apprendront jamais pourquoi tel modèle est meilleur pour tel type de tâche. Je ne suis pas sûr que ce soit grave pour la plupart des gens, de la même façon que peu d’entre nous savent quelles instructions CPU leur compilateur génère. Pour ceux qui construisent vos outils IA internes, en revanche, gardez l’habitude de tester les modèles directement.
Dans Copilot CLI, /model ouvre le sélecteur. Pour la preview des modèles locaux :
# Copilot CLI : activer les fonctions expérimentales, puis choisir un modèle
/experimental on
/model

# VS Code : activer les modèles locaux
"chat.copilot.localModel.enabled": true

# Application Copilot : Settings > Experiments > Local model auto routing
Une règle simple pour les niveaux d’effort :
| Tâche | Niveau |
|---|---|
| Expliquer du code, écrire des tests, petits refactorings, documentation | Standard |
| Corriger un bug qui touche plusieurs fichiers, livrer une fonctionnalité cadrée | High |
| Refactoring de conception, concurrence délicate, plan de migration | Max |
| Besoin d’un comportement identique d’une exécution à l’autre, ou d’un modèle validé par l’équipe | Fixer un modèle précis |
Copilot Fusion marque le moment où le choix du modèle devient de l’infrastructure. Pour la plupart des développeurs, ce sera une amélioration invisible : le bon modèle plus souvent, moins de gaspillage, et un second avis quand la tâche le mérite. L’écart avec la meilleure configuration mono-agent est faible en moyenne et très inégal dans le détail, et c’est justement pour cela qu’il faut le tester sur votre propre code avant de croire le chiffre de qui que ce soit, y compris celui de GitHub.
Pour les équipes des secteurs régulés, la question la plus dure est “pouvons-nous expliquer ce qu’il a fait ?”. Limitez le parc, gardez Standard par défaut, relisez chaque diff et mesurez. Dans ces conditions, Fusion est probablement le meilleur réglage par défaut que Copilot ait livré.
Je vais le tester sur nos outils internes dans les semaines qui viennent. Si vous lancez votre propre pilote, j’aimerais comparer nos résultats.