
Le 31 octobre 2026, l’équipe DeepSeek Harness a publié un essai de conception, Exploring Super-agent Design: Towards a More Autonomous Agent System, accompagné d’un prototype de recherche sous licence MIT, dsh-superagent-prototype. Ce n’est pas un nouveau modèle. C’est une proposition pour le système qui entoure le modèle.
Mon verdict en une ligne : l’architecture mérite d’être copiée, le code mérite d’être lu, et personne dans une banque ne devrait le faire tourner tel quel.
La moitié des posts que j’ai lus cette semaine mélangent trois choses différentes. « DeepSeek SuperAgent Harness » est l’étiquette que la communauté a collée sur l’ensemble, mais il faut séparer les couches pour évaluer quoi que ce soit.
| Nom | Ce que c’est | Sortie |
|---|---|---|
| DeepSeek Harness (DSH) | Runtime d’agent de code open source, licence MIT. Tout est plugin, y compris la boucle de l’agent, au-dessus d’un framework de composition appelé Cordis. Compatible avec d’autres fournisseurs et les endpoints compatibles OpenAI. | 13 août 2026, avec DeepSeek V4 Pro |
| Essai Super-agent | Une proposition d’architecture pour un système d’agents permanent et multitâche. Signé Yujia Qiao pour l’équipe Harness. | 31 octobre 2026 (WeChat et X) |
| dsh-superagent-prototype | Bundle TypeScript v0.1.0 qui tourne comme un profil DSH dédié. Un dépôt GitHub, Feishu en option, un panneau web local. | 31 octobre 2026 |
Le prototype n’est pas un fork. C’est un ensemble de plugins DSH : un plugin Super Agent central, un observateur GitHub et un observateur Feishu, branchés via un fichier de patch Cordis, plus des presets Router et Worker allégés.
Une réserve sur laquelle je reviendrai souvent. Le README précise que le code public diffère du système interne de DeepSeek, et que certaines idées de l’essai sont des pistes futures, pas des fonctionnalités. Dans cet article, « la conception » désigne l’ambition et « le prototype » désigne le code.
Le point de départ de DeepSeek, tous les gros utilisateurs de Claude Code, Codex ou du mode agent de Copilot le ressentent déjà. Un agent qui corrige un bug, c’est réglé. Dix agents sur dix tickets, c’est un autre métier, et ce métier retombe sur vous.
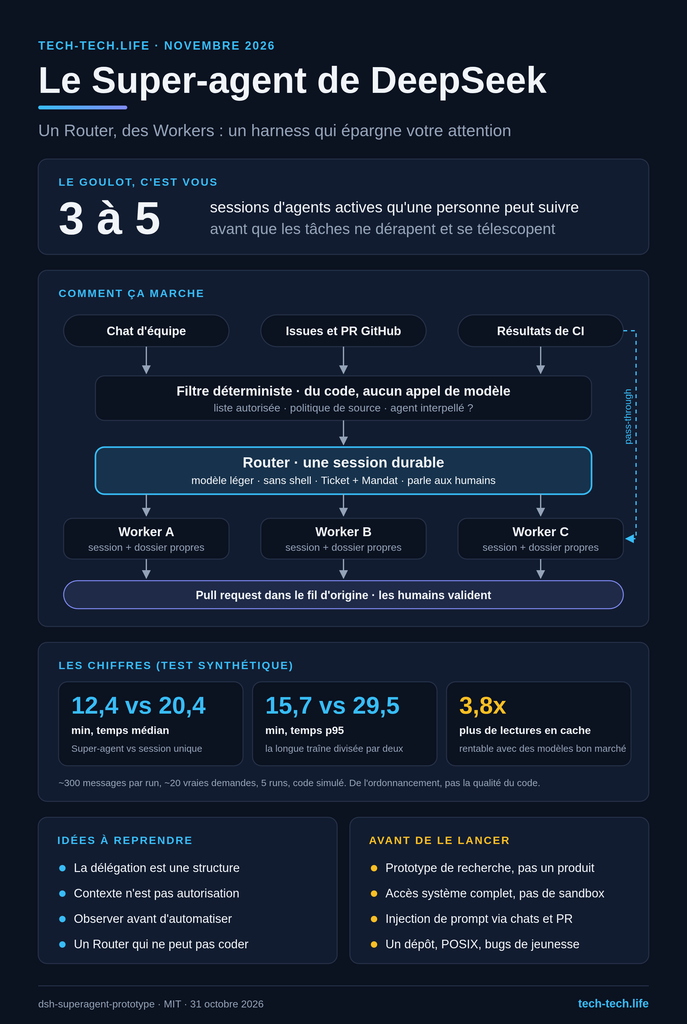
L’équipe observe qu’une personne suit environ trois à cinq sessions actives avant de décrocher. On oublie quelle session attend une validation, laquelle tourne en boucle, et lesquelles modifient en silence la même pull request. C’est une observation de terrain, pas une loi mesurée, mais je n’ai jamais rencontré un développeur qui la contredise.
L’essai fixe quatre objectifs pour un système qui enlève cette charge :
Le principe affiché dans le README le résume bien : consommer le moins d’attention humaine possible et apporter le plus de valeur possible. Je l’afficherais au mur de toute équipe qui construit des agents internes.
La conception rejette les deux options évidentes. Tout envoyer dans une seule grosse session donne un contexte partagé, mais une seule chose à la fois et des tâches qui se contaminent. Ouvrir une session neuve par événement donne de la vitesse, mais aucune continuité, et plusieurs agents qui vous répondent en même temps.
Le compromis tient en deux couches.
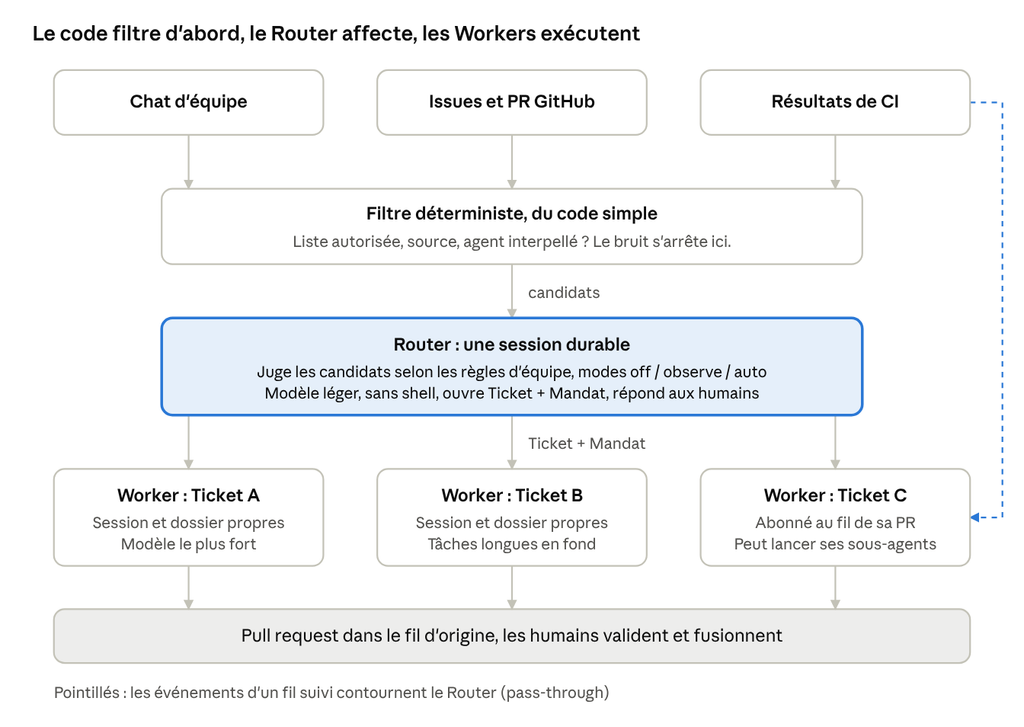
Flux du Super-agent · filtre, Router, Workers
Chaque événement passe un filtre de code avant qu’un modèle ne le voie. Dès qu’un Worker possède un fil, les événements suivants contournent le Router.
Cela inverse un réflexe que je vois dans la plupart des pilotes d’agents en entreprise, où l’« orchestrateur » reçoit le modèle premium. Le Router de DeepSeek ne décompose pas les problèmes. Il affecte et il suit. C’est un travail moins cher.
Un agent permanent reçoit bien plus que des demandes directes. Messages de chat, commentaires de PR, résultats de CI, rappels de calendrier : tout devient un Trigger, et la plupart ne méritent rien.
Les événements liés sont regroupés en Threads : une PR et ses commentaires de revue, un sujet de chat et ses réponses. Dès qu’un Worker possède un Ticket, il s’abonne au Thread, et les événements suivants lui arrivent directement par du code, sans nouvelle décision de routage. DeepSeek appelle cela le pass-through. Les abonnements sont multiples dans les deux sens : deux Workers sur la même PR voient les mêmes événements. Cela leur donne une chance de repérer un conflit. Ce n’est pas un verrou.
L’essai emprunte deux idées aux systèmes informatiques. Inline place directement dans le contexte ce qui sera probablement utile : messages voisins, message parent, commentaires de revue adjacents. Spill garde le reste à l’extérieur, derrière un court résumé et un identifiant qu’on peut déplier plus tard.
Comme événements, Threads et sessions se référencent par identifiant, le Router peut remonter d’un nouveau commentaire à son Thread, du Thread à une session de Worker, puis à une discussion vieille de plusieurs semaines. DeepSeek appelle cela la chaîne de rappel (chain of recall). C’est un chemin d’accès, pas la garantie que le modèle choisira le bon historique. L’équipe classe elle-même la mémoire longue parmi les problèmes non résolus.
C’est la partie la plus mûre à mes yeux, et c’est là que le prototype est plus prudent que le buzz qui l’entoure.
Le contexte n’est pas une autorisation. Dans le modèle d’autorisation du prototype, c’est l’hôte qui applique les listes autorisées, les règles et les Mandats. Messages, commentaires et documents cités sont des entrées pour une décision. Ils ne peuvent pas modifier les permissions. Un commentaire qui arrive sur un Thread suivi atteint le Worker comme contexte et ne lui donne aucun droit nouveau.
Trois modes d’acceptation pour le travail proactif :
| Mode | Ce qui arrive au travail inféré (messages non adressés, messages de bots, relances de personnes hors liste) |
|---|---|
| off | Rien d’inféré ne devient candidat |
| observe (par défaut) | Les candidats sont évalués, un avis positif est journalisé en « aurait accepté ». Rien ne s’exécute. |
| auto | Une évaluation positive accepte le travail |
Les demandes explicites des personnes autorisées fonctionnent dans tous les modes. La documentation conseille de démarrer en observe, de relire les décisions journalisées, puis seulement de passer en auto. DeepSeek aurait déployé son système interne de la même façon. Si vous ne retenez qu’une idée de cette publication pour votre plateforme d’agents, retenez celle-là.
Quelques détails utiles :
Reproduire et corriger en silence. En interne, DeepSeek applique une politique où un bug signalé dans un chat est reproduit en arrière-plan. Si l’agent confirme le bug et trouve un correctif, une pull request apparaît pendant que la discussion continue. Sinon, personne n’en entend parler. Le travail spéculatif coûte du calcul, mais il se jette facilement. Un commentaire publié ou un merge, non. C’est pour ça que la frontière d’autorisation se trouve là.
Une commande longue ne doit pas prendre la conversation en otage. Dans la conception, un outil peut lancer une tâche de fond, rendre la main à la boucle de l’agent et livrer son résultat plus tard sous forme d’événement. L’équipe parle de full-duplex : vous envoyez une correction pendant qu’un build de dix minutes tourne. Dans le prototype, toute commande shell qui dépasse cinq secondes passe en arrière-plan, pour que le Worker continue à recevoir des messages. L’essai précise que le mécanisme asynchrone général existe dans DSH mais n’était pas activé par défaut.
Séparer l’agent de ses machines. Un agent local lie trois choses : le calcul qui fait tourner la boucle, l’état de la session et l’environnement où les commandes s’exécutent. Fermez le portable, les trois disparaissent. La conception les découple en deux temps. L’état vit dans un stockage persistant, donc la boucle peut redémarrer n’importe où. Ensuite, la boucle atteint les environnements d’exécution via de petits démons. DeepSeek appelle cela Bring Your Own Machine : votre poste, avec ses modifications non commitées, son GPU et son accès intranet, devient un point d’exécution parmi des sandboxes cloud. L’équipe cite le travail d’Anthropic sur les managed agents pour la séparation cerveau / mains, et met l’accent sur les machines personnelles à connexion intermittente. Précision : c’est de la conception, pas une fonctionnalité du prototype.
Un Watchdog pour les agents vivants mais bloqués. Un processus peut tourner sans avancer : il relance la même commande en échec, perd le fil de sa tâche, attend une dépendance morte. La conception propose une session d’agent séparée, réveillée sur planning, qui vérifie l’infrastructure, juge si les Workers progressent et tente des réparations. Aucun taux de détection ou de réparation n’est fourni. Le prototype documente seulement un contrôle horaire externe d’état et de reprise, bien plus limité.
Discipline de communication. L’équipe indique qu’une limite d’environ 100 mots pour les réponses en messagerie instantanée a bien fonctionné chez elle, tandis que les PR portent tout le contexte. Le détail va là où il a sa place, le chat reste pour les décisions.
Le Super-agent a terminé des tâches simulées environ 39 % plus vite en médiane qu’une session unique, pour environ 3,8 fois plus de lectures en cache. Lisez le protocole avant de citer ce chiffre.
Chaque run envoyait environ 300 messages de chat et de CI, dont une vingtaine de vraies demandes de travail, le reste étant du bavardage, des relances et des annulations. Quatre conceptions, cinq runs chacune. Le code lui-même était simulé par un outil qui consommait du temps, et les intervalles de messages et durées de travail ont été réduits, pas les appels de modèle. On mesure de l’ordonnancement, pas la qualité du code.
| Conception | Temps médian (p50) | p95 | Lectures en cache par run |
|---|---|---|---|
| Super-agent | 12,4 min | 15,7 min | 23,2 M |
| Super-agent sans pass-through | 12,6 min | 15,5 min | 31,8 M |
| Session unique, outil sous-agent, prompt neutre | 20,4 min | 29,5 min | 6,1 M |
| Session unique, outil sous-agent, prompt pro-délégation | 13,8 min | 29,0 min | 10,8 M |
Source : essai de DeepSeek, repris par Kingy AI et Dataconomy. Chiffres de l’équipe, non reproduits indépendamment.
Trois résultats me frappent.
Côté coût, l’argument de DeepSeek est que cette conception n’a de sens économique qu’avec des modèles rapides et bon marché. Les lectures en cache se multiplient, ce qui reste abordable au tarif « flash » et devient cher au tarif des modèles de pointe. Ce qui manque à l’évaluation : des tâches réelles, la justesse du code, les PR acceptées, le temps de revue humaine, la charge de notifications et des tests adverses. Ce sont pourtant les chiffres dont une banque aurait besoin.
Le dépôt a dépassé 17 000 étoiles GitHub en moins de quatre jours. Des étoiles ne sont pas des déploiements, alors voici ce que vous obtenez en le clonant.
Ce qu’il fait. Il surveille un dépôt GitHub et, en option, Feishu. Quand une personne autorisée demande du travail, il ouvre un Ticket, le traite dans sa propre session DSH et son propre répertoire, et répond dans la conversation d’origine, souvent par une pull request. Un panneau web local montre ce qui attend un humain. L’installation est assez longue pour que le README recommande de se faire guider par un agent de code via SETUP.md. La documentation est numérotée de 000 à 008, de la philosophie à un guide pour ajouter une nouvelle source, et c’est la meilleure partie de la publication.
Prérequis. Node.js 22.19+ ou 24+, Git 2.32+, Python 3.8+, tmux et GitHub CLI 2.48+, plus une version compatible de DSH (^0.2.1-alpha.2). En pratique, c’est POSIX uniquement. Des retours de la communauté montrent que Windows natif demande des correctifs, ou WSL.
Les avertissements qui comptent :
Rien de scandaleux. DeepSeek a dit clairement qu’une grande partie de ce code a été écrite par des agents et qu’il s’agit de code de recherche. C’est une référence à lire et dont s’inspirer, pas un produit à installer lundi matin.
Si vous avez suivi ma série sur le prompt, le context et le harness engineering, cette publication est la troisième couche rendue concrète. Le modèle est une matière première. Ce qui décide de la vitesse, du coût et de la sécurité, c’est le système autour.
Pas vraiment, et ce n’est pas grave. Les schémas superviseur / exécutant, l’event sourcing, les tâches de fond et les watchdogs ont des décennies. Anthropic a publié la séparation cerveau / mains, et DeepSeek le cite. Des agents de code hébergés transforment déjà une issue en PR. Ce qui est nouveau, c’est un labo qui publie tout le modèle opérationnel en clair : le modèle de domaine, les règles d’autorisation, l’expérience, les échecs, sous licence MIT. C’est le document de référence le plus utile sur l’exploitation multi-agents que j’ai lu cette année.
Le schéma convient bien à une équipe de développement régulée, à condition de placer les contrôles là où la conception leur laisse déjà de la place. Voici un scénario fictif mais réaliste.
Le contexte. Une équipe de douze personnes maintient le service de reporting de portefeuilles d’une banque privée. Un système de type Super-agent surveille leur dépôt Git et le canal de support interne utilisé par le helpdesk des banquiers privés.
Ce que l’agent n’obtient jamais dans cette histoire : des identifiants de production, des données clients réelles, un droit de merge ou une validation de gestion du changement. Tout cela reste humain.
DeepSeek n’a pas livré un produit. Il a livré un modèle opérationnel pour les agents, avec ses compromis, ses chiffres et ses problèmes ouverts sur la table. La leçon pour quiconque construit une plateforme d’agents interne est simple : arrêtez d’optimiser la conversation avec un agent, et concevez le système qui évite à vos équipes d’avoir beaucoup de conversations.
Lisez l’essai. Lisez les documents numérotés du dépôt, dans l’ordre. Puis reprenez les quatre idées qui comptent, dans cet ordre : un filtre déterministe, des Mandats qui séparent contexte et autorisation, l’observation avant l’automatisation, et un Router incapable de faire le travail lui-même.
J’aimerais beaucoup entendre les équipes qui testent ce schéma en environnement régulé. Que mettriez-vous devant le filtre ?