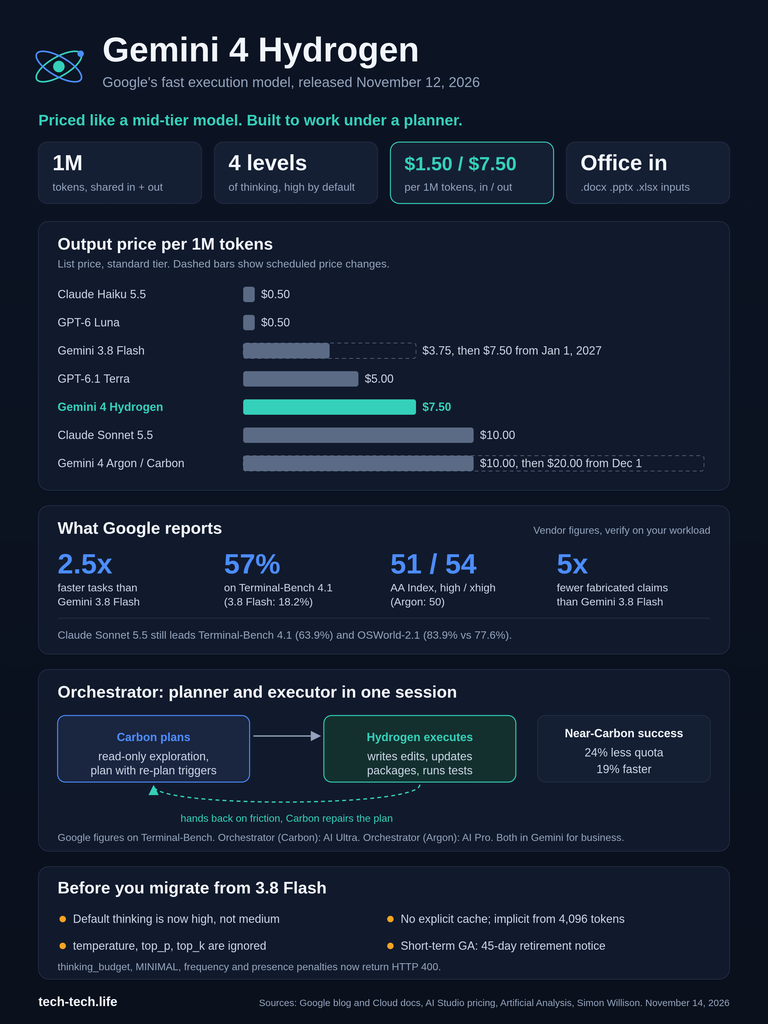

Google a lancé Gemini 4 Hydrogen le 12 novembre 2026. C’est le troisième modèle de la génération Gemini 4, après Argon et Carbon, et celui que la plupart des gens utiliseront sans jamais le choisir : il fait désormais tourner les fonctions IA de Google Search dans le monde entier et se cache derrière la sélection automatique de modèle de l’application Gemini gratuite. Côté développeurs, il coûte 1,50 $ par million de tokens en entrée et 7,50 $ par million en sortie.
Ma lecture, après avoir passé au crible les trois billets de lancement de Google, le guide développeur Google Cloud et les premiers chiffres indépendants : Hydrogen est un excellent modèle d’exécution, tarifé comme un modèle de milieu de gamme, et pensé pour travailler sous les ordres d’un modèle plus puissant. Si vous le rangez à côté de Claude Haiku 5.5 ou de GPT-6 Luna parce qu’il remplace un « Flash », vous allez mal le juger. Ses vrais concurrents s’appellent Claude Sonnet 5.5 et GPT-6.1 Terra.
Cet article est construit en couches. Les développeurs y trouveront la fiche technique et les pièges de migration. Les architectes, le pattern Orchestrator. Les décideurs, les questions de prix, de cycle de vie et de données.
Hydrogen a commencé comme une rumeur. Le 27 octobre, un post sur X affirme que Gemini 4 Flash est en test interne sous le nom de code Hydrogen. Le 4 novembre, d’autres comptes parlent de cinq checkpoints Hydrogen tournant à 300 à 500 tokens par seconde, sans capture d’écran ni identifiant de modèle. Le 11 novembre, Business Insider révèle que des employés de Google testent un modèle « rapide » nommé Hydrogen sur Jetski, la plateforme de développement interne. Le lendemain, Google le lance.
| Ce qui circulait avant le lancement | Ce que Google a livré |
|---|---|
| Hydrogen est le nom de code du tier Gemini 4 Flash | Hydrogen est devenu le nom commercial ; les billets de Google ne disent jamais « Gemini 4 Flash » |
| 300 à 500 tokens par seconde | Aucun chiffre de Google ; Artificial Analysis mesure environ 188 |
| Sortie vers le 18 novembre | Sorti le 12 novembre |
| Cinq checkpoints en test A/B | Non commenté par Google |
Le nom était juste, le chiffre de vitesse invérifiable, la date décalée de six jours. Et le seul chiffre qui compte vraiment pour votre budget, le prix, n’a jamais fuité. À garder en tête la prochaine fois qu’un fil de « leaks » devient viral dans votre fil d’actualité.
Tout ce qui suit vient du guide développeur Google Cloud et de la page modèle d’AI Studio.
| Élément | Gemini 4 Hydrogen |
|---|---|
| Identifiant | gemini-4-hydrogen, disponibilité générale, une version stable |
| Fenêtre de contexte | 1 048 576 tokens, partagés entre entrée, réflexion et sortie |
| Sortie par requête | 65 536 tokens par segment ; jusqu’à la fenêtre complète avec le « long decode » (API v1beta1 uniquement) |
| Niveaux de réflexion | low, medium, high (par défaut), xhigh |
| Entrées | Texte, image, audio, vidéo, PDF, plus fichiers Word, PowerPoint, Excel et OpenDocument |
| Sortie | Texte uniquement : ni génération d’image, ni audio, ni Live API |
| Outils | Function calling, sorties structurées, exécution de code, computer use, file search, URL context, grounding Google Search et Maps |
| Cache | Implicite uniquement, sur des préfixes d’au moins 4 096 tokens ; entrée en cache remisée de 95 % |
| Régions Google Cloud | global, us, eu |
| Cycle de vie | GA « court terme », préavis de retrait de 45 jours minimum |
Deux lignes méritent qu’on s’y arrête. L’entrée native des fichiers Office permet de passer un contrat .docx ou un budget .xlsx directement dans un résultat d’outil, sans étape de conversion. Et « GA court terme » signifie que Google vous annonce déjà que ce modèle sera remplacé, avec parfois seulement 45 jours de préavis.
La grille tarifaire de Google ne prend son sens que si l’on regarde toute la famille et ses changements programmés.
| Modèle | Entrée ($/1M tokens) | Sortie ($/1M tokens) | Changement prévu |
|---|---|---|---|
| Gemini 3.5 Flash-Lite | 0,30 | 2,50 | Aucun annoncé |
| Gemini 3.8 Flash | 0,75 | 3,75 | 1,50 / 7,50 au 1er janvier 2027 |
| Gemini 4 Hydrogen | 1,50 | 7,50 | Aucun annoncé |
| Gemini 4 Argon | 2,00 | 10,00 | 4,00 / 20,00 au 1er décembre 2026 |
| Gemini 4 Carbon | 2,00 | 10,00 | 4,00 / 20,00 au 1er décembre 2026 |
Les autres modes : Batch et Flex à 0,75 $ / 3,75 $, Priority à 2,70 $ / 13,50 $, entrée en cache à 0,075 $. Il existe un tier API gratuit avec des limites de débit, et la page de prix précise que les contenus du tier gratuit servent à améliorer les produits Google, contrairement à ceux du tier payant.
Voici ce que la plupart des articles de lancement ont oublié. Aujourd’hui, Hydrogen n’est que 25 % moins cher qu’Argon et Carbon, comme l’a relevé Simon Willison. Au 1er décembre, l’écart passe à 75 %. Au 1er janvier, Gemini 3.8 Flash coûtera exactement le prix d’Hydrogen. Google repositionne toute son échelle tarifaire autour d’Hydrogen, et dès janvier, rester sur 3.8 Flash ne fera plus économiser un centime. Si vous gérez un budget IA, modélisez votre facture du premier trimestre 2027 dès ce mois-ci.
Le déploiement dans Search est le vrai titre discret de ce lancement. Robby Stein, VP Produit de Search, le présente comme la plus grosse mise à niveau de modèle qu’ait connue Search : meilleure compréhension des questions en plusieurs parties, un « query fan-out » plus large, davantage de tableaux et de réponses visuelles. Pour beaucoup de gens, Hydrogen va devenir ce à quoi ressemble une « réponse IA ».
La plupart des chiffres en circulation viennent de Google. Voici ce qu’affirment l’annonce officielle et le billet Antigravity :
Côté indépendant, Artificial Analysis mesure environ 188 tokens de sortie par seconde, et en moyenne 1,3 minute par tâche de l’index en low contre 13,7 minutes en xhigh, selon kie.ai. Sur ce même index, Hydrogen en xhigh se place un point sous Claude Sonnet 5.5 et GPT-6.1 Sol à leurs réglages maximum (54 contre 55).
Trois choses à garder en tête avant de citer ces chiffres en comité de pilotage.
Le niveau de réflexion compte autant que le nom du modèle. Le flatteur 54, c’est xhigh, le réglage le plus lent et le plus gourmand en tokens. Le niveau high par défaut donne 51. Une comparaison qui ne précise pas le niveau utilisé n’en est pas une.
Les plus gros écarts sont sur les benchmarks les plus fragiles. Vending-Bench 2 mesure un solde bancaire simulé, pas un taux de réussite, et Epoch a signalé des faiblesses de notation dans les tâches publiques d’Agents’ Last Exam. Les concurrents d’Hydrogen gardent l’avantage sur les tests terminal et computer use, mieux établis. Les chiffres de sécurité arrivent sans point de comparaison nommé : à vérifier sur vos propres cas d’usage.
Rapide et économique, ça se voit dans le résultat. Simon Willison a passé son test du « pélican à vélo » sur les trois modèles Gemini 4. En niveau high, Hydrogen a produit son dessin en 19 secondes pour environ 4 centimes. Argon a mis environ deux minutes et demie pour 17 centimes, Carbon environ quatre minutes pour 20 centimes. Le pélican d’Hydrogen était aussi nettement plus simple. Pour des boucles agentiques où chaque étape est courte et vérifiable, le compromis est excellent. Pour du travail créatif ou de design ouvert, les grands frères justifient encore leur prix.
Commençons par les prix catalogue, tier standard, par million de tokens. Pour les modèles non Google, j’ai utilisé des comparateurs tiers.
| Modèle | Entrée ($/1M) | Sortie ($/1M) | Positionnement |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 (jusqu’à 100K de contexte) | 0,50 | Entrée de gamme |
| GPT-6 Luna | 0,10 (jusqu’à 272K de contexte) | 0,50 | Entrée de gamme |
| GPT-6.1 Terra | 1,00 | 5,00 | Milieu de gamme |
| Gemini 4 Hydrogen | 1,50 | 7,50 | Exécution rapide |
| Claude Sonnet 5.5 | 2,00 | 10,00 | Milieu de gamme |
Au token, Hydrogen coûte 15 fois le prix de Haiku 5.5 et de GPT-6 Luna. Ce seul ratio tranche la question du positionnement : Hydrogen ne vient pas chercher votre trafic de classification et de routage. Il vient chercher le travail agentique que vous envoyez aujourd’hui à Sonnet 5.5 ou à Terra.
Sur ce terrain, la model card de Google place Hydrogen face à Claude Sonnet 5.5. Lignes choisies, chiffres fournis par l’éditeur :
| Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|
| SWE-sweep (correction de bugs sur dépôts) | 13,5 % | 3,1 % |
| Agents’ Last Exam v1.1 | 71,6 % | 60,4 % |
| AutomationBench-AA | 76,1 % | 71,8 % |
| Terminal-Bench 4.1 | 57,0 % | 63,9 % |
| OSWorld-2.1 (computer use, sous-ensemble offline) | 77,6 % | 83,9 % |
| Terminal-Bench-Science 0.1 | 51,4 % | 59,9 % |
Sur les dix lignes de la model card, Hydrogen en remporte sept, et GPT-6.1 Terra obtient 5,8 % sur SWE-sweep. Sonnet 5.5 garde les lignes terminal et computer use. Artificial Analysis estime que faire tourner son index coûte environ trois fois moins cher sur Hydrogen que sur Sonnet 5.5.
Ma grille pratique :
L’annonce la plus importante du 12 novembre tient dans une entrée de menu de Google Antigravity : Orchestrator, qui associe Hydrogen à Carbon (ou Argon) dans une même session d’agent.
L’équipe Antigravity décrit le flux ainsi. Carbon démarre en lecture seule : il explore les dépendances, lève les ambiguïtés et rédige un plan avec des déclencheurs de replanification explicites. Hydrogen prend le relais pour écrire les modifications, mettre à jour les paquets et lancer les tests. Quand Hydrogen bloque, il rend la main à Carbon, qui inspecte l’état, répare le plan et relance l’exécution. Google annonce un taux de réussite proche de celui de Carbon, avec 24 % de quota en moins et des tâches bouclées 19 % plus vite en moyenne. Un détail pour les lecteurs attentifs : l’annonce principale attribue ces chiffres à Terminal-Bench 4.0, le billet Antigravity à Terminal-Bench 4.1.
Google oppose explicitement cette approche au routeur statique que beaucoup d’entre nous ont construit : deviner la difficulté au premier prompt, puis envoyer toute la tâche au modèle le moins cher qui semble suffire. Cette approche casse sur les agents longs, parce que la difficulté change en cours de route. Orchestrator bascule dans les deux sens, autant de fois que la trajectoire l’exige.
Si vous suivez mes articles sur l’usine logicielle IA, c’est le pattern sur lequel je reviens sans cesse : un modèle frontière pour le jugement, un modèle rapide pour le volume, et un contrat de passation explicite entre les deux. Google en a fait une fonctionnalité produit. Vous pouvez construire la même chose avec n’importe quelle paire de modèles, et le SDK Antigravity permet d’attribuer des rôles à Hydrogen et Carbon dans le code. Orchestrator (Carbon) est réservé aux abonnés Google AI Ultra, Orchestrator (Argon) aux abonnés Pro, et les entreprises ont accès aux deux via Gemini for business.
Passer de Gemini 3.8 Flash à Hydrogen demande plus qu’un changement d’identifiant. D’après le guide développeur :
Gemini 4 Hydrogen est le meilleur modèle d’exécution à coût ajusté que Google ait livré, et pour beaucoup de workflows de code agentique et de traitement documentaire, c’est désormais la référence à battre. Ne laissez simplement pas le mot « Flash » des fuites fixer vos attentes sur le prix : c’est un modèle de milieu de gamme en coût, un excellent exécutant en pratique, et il donne le meilleur de lui-même quand un modèle plus puissant fait la planification. La vraie histoire de ce lancement, c’est Orchestrator, et les équipes qui adoptent le pattern planificateur-exécutant y gagneront, quel que soit le fournisseur qui mènera la course au prochain trimestre.