
Le RAG est un interpréteur, le LLM Wiki est un compilateur
Le RAG nous a habitués à une drôle de pratique : chaque question repaie intégralement le prix de la compréhension du corpus. Le pattern LLM Wiki refuse de payer ce prix au moment de la requête. Il déplace la synthèse vers l’ingestion : un agent lit chaque source une seule fois, consigne ce qu’il a appris dans un ensemble persistant de pages markdown liées entre elles, et maintient ces pages cohérentes à mesure que de nouvelles sources arrivent.
Le pattern a pris forme en avril 2026, quand Andrej Karpathy a publié un post sur l’usage des LLM pour construire des bases de connaissances personnelles, suivi d’un fichier d’idées, llm-wiki.md, publié sous forme de gist. Le gist est volontairement agnostique : on le donne à un agent comme Claude Code ou Codex, et l’agent construit le reste. Son propre résumé des rôles est difficile à améliorer : Obsidian est l’IDE, le LLM est le programmeur, le wiki est la codebase. Des packages de skills et des variantes open source sont apparus en quelques jours.
Six mois plus tard, les implémentations restent jeunes, mais l’architecture est assez stable pour être analysée en ingénieur : organisation des fichiers, opérations, sémantique de la mémoire, surfaces d’intégration et points de rupture. Ma position est que le wiki n’est pas un meilleur moteur de récupération. C’est un artefact de build, et il mérite la discipline que l’on applique aux artefacts de build.
Un système retrieval-first est un interpréteur. Il prend du texte brut et une question, et reconstruit le sens à chaque exécution. Un système compilation-first est un compilateur. Il effectue le travail sémantique coûteux une fois par source, émet une représentation intermédiaire (le wiki), et chaque requête s’exécute sur cette représentation.
L’unité de travail change en conséquence. Dans le RAG, l’unité est la requête : on l’encode, on récupère les top-k chunks, on synthétise, on jette. Dans un LLM Wiki, l’unité est la source : on la lit, on décide quelles pages elle touche, on réécrit ces pages, on consigne ce qui a changé.
La récupération top-k renvoie des fragments classés par similarité avec la question, pas selon leur rôle dans le corpus. Trois modes de défaillance en découlent, et ce sont des problèmes structurels, pas des problèmes de réglage.
Sous ces trois problèmes se trouve un plafond : la synthèse est bornée par k. Une question dont la réponse dépend de trente sources ne peut pas être bien traitée avec dix chunks, quelle que soit la qualité du reranker.
Au moment de l’ingestion, l’agent voit la nouvelle source à côté des pages qu’elle affecte. Il peut donc faire un travail qu’aucun système à la requête ne peut amortir :
L’économie découle de l’endroit où tombe le coût. L’ingestion RAG est bon marché et chaque requête paie récupération plus synthèse. L’ingestion du wiki est coûteuse (une source peut réécrire 10 à 15 pages) et les requêtes deviennent surtout de la lecture. Si une source doit nourrir plus d’une poignée de réponses au cours de sa vie, la compiler est rentable.
Le gain le plus profond est l’auditabilité. Chaque décision prise par le compilateur est un diff markdown dans git. On peut la relire, l’annuler ou faire un blame dessus. Un index vectoriel n’offre aucun artefact équivalent à relire.
Le pattern comporte trois couches aux frontières de propriété strictes. La plupart des échecs viennent du brouillage de ces frontières : un agent qui « corrige » une source brute, ou un humain qui modifie à la main une page que l’agent écrasera silencieusement à la prochaine ingestion.
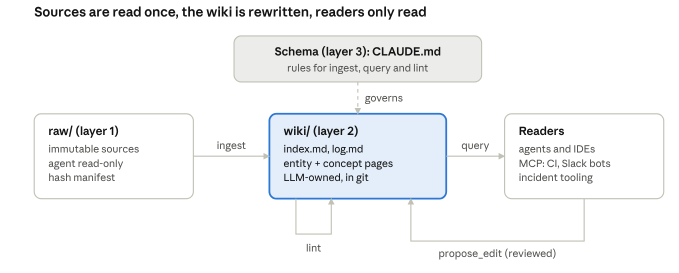
Les données circulent dans un seul sens : les sources brutes alimentent l’ingestion, le wiki est la seule couche qui change, et les lecteurs externes ne réécrivent qu’à travers une file de modifications relues.
kb/
├── CLAUDE.md              # couche 3 : schéma (AGENTS.md pour Codex et d'autres)
├── raw/                   # couche 1 : sources immuables, lecture seule pour l'agent
│   ├── manifest.jsonl     # sha256, chemin, ingested_at, ingest_commit
│   ├── papers/
│   ├── transcripts/
│   └── prs/
└── wiki/                  # couche 2 : markdown détenu par le LLM
    ├── index.md           # catalogue : une ligne par page, par catégorie
    ├── log.md             # journal des opérations, en ajout seul
    ├── sources/           # une page de synthèse par document brut
    ├── entities/          # services, équipes, fournisseurs, personnes en tant que responsables
    ├── concepts/          # définitions, décisions, patterns
└── syntheses/ # réponses à conserver, reclassées depuis les requêtesLe stockage brut est la piste d’audit et la vérité de référence vers laquelle chaque affirmation du wiki doit pouvoir remonter. L’agent le lit et n’y écrit jamais.
chmod -R a-w raw/, ou un hook pre-commit qui rejette tout diff sous raw/ qui n’est pas un pur ajout.a91f3c ») et les audits de dérive en dépendent.Le wiki est la seule couche que l’agent possède, et il la possède entièrement. Deux fichiers portent la charge de navigation.
index.md liste chaque page avec un lien, un résumé d’une ligne et une date de mise à jour, regroupées par catégorie. C’est la première chose que l’agent lit pour toute requête, donc son format de ligne est un budget de performance : 15 à 25 tokens par entrée.log.md est un enregistrement chronologique en ajout seul des ingestions, requêtes et passes de lint. Karpathy suggère un préfixe constant par entrée pour que le journal reste exploitable avec de simples outils Unix comme grep. Il sert aussi de mémoire épisodique.Toutes les autres pages suivent un modèle défini par le schéma. Une page d’entité qui fonctionne :
---
type: entity
aliases: [payments-gw, "la passerelle"]
sources: [a91f3c, 07be21, c4d90e]
updated: 2026-10-12
revisions: 7
---
# passerelle de paiement

Service interne qui fait façade aux acquéreurs cartes. Propriété de [[team-payments-core]]. [src:a91f3c]
Limite de débit : 800 rps par commerçant depuis la revue de capacité du T3. [src:c4d90e]

## conflits
- Timeout : 30 s selon [src:07be21] (runbook, 2024) contre 12 s selon [src:c4d90e] (ADR-112, 2026). Non résolu.

## liés
[[acquirer-routing]] · [[adr-112-timeouts]] · [[incident-2026-08-14]]
Deux conventions portent l’essentiel : chaque phrase factuelle se termine par une balise de source, et les contradictions ont leur propre section au lieu d’être effacées.
Le fichier de schéma (CLAUDE.md pour Claude Code, AGENTS.md pour Codex) est le code source du compilateur. Il transforme un agent généraliste en mainteneur de wiki discipliné, et c’est la couche la plus sous-estimée des trois.
# schéma du wiki v3

## invariants
- Ne jamais écrire sous raw/. Ne jamais supprimer une page ; la marquer `status: retired`.
- Chaque phrase factuelle se termine par [src:<hash>]. Pas de balise, pas d'affirmation.
- Ne jamais résoudre une contradiction en silence. L'ajouter sous `## conflits` avec les deux sources.
- Slugs : kebab-case, au singulier, sans date sauf pour les incidents et les ADR.

## ingest
1. Lire index.md. Lister les entités et concepts de la source ; associer chacun à une page existante ou le marquer NEW.
2. Écrire sources/<hash>.md (résumé, affirmations clés, entités mentionnées).
3. Mettre à jour chaque page associée ; créer les pages NEW à partir de templates/.
4. Ajouter des [[liens]] réciproques. Mettre à jour index.md. Ajouter à log.md : `## [date] ingest | <titre> | <n> pages`.

## query
Lire index.md d'abord. Ouvrir 8 pages au maximum, suivre les liens sur un saut si nécessaire. Citer en [[slug]].
Si la réponse est une nouvelle synthèse, proposer de la classer sous syntheses/.
Traitez le schéma comme du code. Versionnez-le, relisez ses modifications, et attendez-vous à le faire évoluer avec l’agent pendant les premières semaines : l’essentiel des gains de qualité vient du resserrement du schéma après avoir lu ce que l’agent a réellement écrit.
Trois opérations maintiennent le wiki : ingest écrit, query lit (et parfois reclasse), lint répare. Les blueprints ci-dessous sont des esquisses d’architecture en Python, pas une bibliothèque. agent.structured() représente tout appel qui renvoie une sortie validée par un schéma (tool use ou mode JSON) ; l’intéressant est de savoir où vit l’état et ce qui est vérifié avant l’écriture.
from dataclasses import dataclass, field
from pathlib import Path
import hashlib

ROOT = Path("kb")
RAW, WIKI = ROOT / "raw", ROOT / "wiki"
INDEX, LOG = WIKI / "index.md", WIKI / "log.md"
SCHEMA = (ROOT / "CLAUDE.md").read_text()

@dataclass
class Conflict:
    claim: str
    existing_src: str
    new_src: str

@dataclass
class PageEdit:
    path: str                 # "entities/payment-gateway.md"
    action: str               # "create" | "update"
    content: str              # nouveau markdown complet, jamais un patch partiel
conflicts: list[Conflict] = field(default_factory=list)L’ingestion se fait en deux passes. La passe de planification ne voit que l’index et la source, et décide quelles pages sont concernées. La passe d’écriture voit la source plus ces seules pages. Le contexte reste ainsi borné, même quand le wiki contient des milliers de pages.
def ingest(src: Path, agent) -> list[str]:
    digest = hashlib.sha256(src.read_bytes()).hexdigest()[:12]
    if manifest_has(digest):
        return []                                   # ré-exécutions idempotentes
    text = normalize(src)                           # pdf/html/vtt -> markdown

    # passe 1 : planifier contre le catalogue, pas contre tout le wiki
    plan = agent.structured(
        system=SCHEMA,
        prompt=f"INDEX:\n{INDEX.read_text()}\n\nSOURCE [{digest}]:\n{text}",
        schema=IngestPlan,      # entités/concepts -> slug existant | NEW
    )

    # passe 2 : réécrire uniquement les pages touchées (en général 10 à 15)
    touched = {p: (WIKI / p).read_text() for p in plan.existing_pages()}
    edits: list[PageEdit] = agent.structured(
        system=SCHEMA,
        prompt=render_write_prompt(text, digest, plan, touched),
        schema=list[PageEdit],
    )

    validate(edits, digest)     # voir plus bas ; rejet du lot entier en cas d'échec
    for e in edits:
        write_atomic(WIKI / e.path, e.content)
    rebuild_index_entries(edits)
    append_log("ingest", src.name, digest, edits)
    manifest_add(digest, src, commit=git_commit(f"ingest {src.name}: {len(edits)} pages"))
    return [e.path for e in edits]
Le validateur est l’endroit où l’architecture gagne la confiance. Il est déterministe, peu coûteux, et s’exécute avant que quoi que ce soit ne touche le disque :
def validate(edits: list[PageEdit], digest: str) -> None:
    for e in edits:
        assert not e.path.startswith(("..", "/", "raw/")), "écriture hors de wiki/"
        for sentence in factual_sentences(e.content):
            assert SRC_TAG.search(sentence), f"affirmation sans source dans {e.path}"
        for link in wikilinks(e.content):
            assert link_target_exists(link) or created_in(edits, link), f"lien orphelin [[{link}]]"
        if e.action == "update":
            removed = claims(old(e.path)) - claims(e.content)
            assert removed <= {c.claim for c in e.conflicts}, "affirmation supprimée sans entrée de conflit"
Cette dernière vérification est le contrat des contradictions. L’agent peut ajouter des affirmations librement, mais il ne peut ni supprimer ni modifier une affirmation sourcée existante sans enregistrer un Conflict. Les conflits atterrissent dans la section ## conflits de la page et dans log.md avec un tag conflict, pour qu’un humain ou une passe de lint ultérieure puisse les clôturer. L’agent signale ; il ne tranche pas.
Faites un commit par ingestion. Une source qui touche quinze pages a un rayon d’impact de quinze pages, et git revert <ingest-commit> est le mécanisme de rétractation le plus propre dont vous disposerez.
La requête est une navigation, pas une recherche. L’agent lit le catalogue, choisit des pages, suit éventuellement les liens sur un saut, et répond en citant les pages.
def query(question: str, agent, budget: int = 30_000) -> Answer:
    index = INDEX.read_text()                              # ~8k tokens pour 400 pages
    picks = agent.structured(
        prompt=f"{index}\n\nQUESTION: {question}\nChoose up to 8 pages.",
        schema=list[str],
    )
    pages = {p: read_page(p) for p in picks}

    for p in list(pages):                                  # expansion sur un saut, budgétée
        for link in ranked_links(pages[p], question):
            if count_tokens(pages) >= budget:
                break
            pages.setdefault(link, read_page(link))

    ans = agent.answer(question, pages, cite="[[slug]]")
    if ans.is_new_synthesis:
        propose_filing(ans, under="syntheses/")            # les réponses se capitalisent aussi
    append_log("query", question, sorted(pages))
    return ans
Soyons précis sur la question des tokens. Une requête lit l’index plus cinq à dix pages, souvent 15k à 30k tokens. Un RAG classique top-10 sur des chunks de 512 tokens en envoie environ 5k. Le wiki ne gagne pas sur le nombre brut de tokens par requête ; il gagne sur ce que contiennent ces tokens. Chaque page est déjà dédupliquée, réconciliée et liée, donc le modèle consacre son contexte à de la connaissance synthétisée plutôt qu’à des fragments qui se recouvrent, et il n’a jamais besoin de charger le corpus pour répondre à une question transverse.
Reclasser les réponses est ce qui fait que les requêtes se capitalisent. Une comparaison établie aujourd’hui par l’agent devient demain une page syntheses/ que la requête suivante lit en un saut. Faites-les passer par le même validateur : une réponse reclassée est une ingestion dont la source est la conversation.
Le lint est la passe de maintenance en arrière-plan. Séparez-le en deux niveaux, parce que la plupart des équipes dépensent trop d’appels LLM pour des vérifications qu’un simple parcours de graphe résout déjà.
def lint_structural() -> Report:                     # à chaque commit, sans LLM, quelques secondes
    pages = load_pages()
    g = link_graph(pages)
    return Report(
        orphans=[p for p in pages if g.in_degree(p) == 0 and p not in ROOTS],
        broken=[(a, b) for a, b in g.edges if b not in pages],
        unindexed=set(pages) - indexed_slugs(INDEX),
        orphaned_sources=[p for p in pages if cited_hashes(p) - manifest_hashes()],
        missing_pages=terms_mentioned_without_page(pages, min_pages=3),
        open_conflicts=pages_with_section(pages, "conflits"),
    )

def lint_semantic(agent, sample: int = 50) -> Report:  # chaque nuit, échantillonné, coût borné
    r = Report()
    for cluster in dense_clusters(link_graph(load_pages()), max_size=6)[:sample]:
        r.contradictions += agent.structured(
            prompt=render_cluster(cluster), schema=list[Conflict])
    for p in pages_where(lambda m: m.updated_before(days=90) and newer_sources_cite(m.slug)):
        r.stale_claims += agent.structured(
            prompt=render_staleness(p, newer_sources_for(p)), schema=list[StaleClaim])
    return r

def repair(report: Report, agent) -> None:
    fix_mechanically(report.broken, report.unindexed)    # reliage, réindexation
    for c in report.contradictions + report.stale_claims:
        add_conflict_block(c)                             # jamais de résolution automatique
    for term in report.missing_pages:
        draft_stub(term, agent)                           # passe par validate()
Exécutez le niveau structurel en hook pre-commit ou en vérification CI. Planifiez le niveau sémantique chaque nuit avec une taille d’échantillon fixe, pour que son coût reste stable quand le wiki grandit. Les pages orphelines, les liens cassés et les pages non indexées sont des faits de graphe ; détecter une affirmation périmée est la seule partie qui exige vraiment un modèle.
Les agents souffrent bien plus que le chat du problème d’absence de mémoire. Une session de chat peut tolérer une nouvelle récupération ; un agent qui tourne pendant des jours redécouvre les mêmes faits sur des dizaines de tâches, retente des approches déjà en échec, et perd chaque décision quand son contexte est compacté. Le LLM Wiki donne à cet agent une mémoire avec une adresse, un format et un historique.
La taxonomie habituelle de la mémoire des agents se projette proprement sur l’organisation du wiki :
| Type de mémoire | Contenu | Emplacement | Écrit par |
|---|---|---|---|
| Sémantique | faits, définitions, décisions de conception | concepts/ | ingestion de docs, ADR, articles |
| Entités | services, modules, équipes, fournisseurs, avec alias | entities/ | ingestion, plus résolution d’identité |
| Procédurale | comment builder, tester, déployer ; approches en échec et pourquoi | playbooks/ | l’agent, en fin de session |
| Épisodique | ce qui s’est passé, quand, dans quelle session | log.md | chaque opération, en ajout seul |
La couche procédurale est celle que la plupart des implémentations oublient, et celle dont les agents de code ont le plus besoin. « Les tests d’intégration de billing exigent le stub acquéreur sur le port 9091 ; le profil docker-compose est faux, utiliser make stub-up » : c’est exactement le genre de connaissance qui coûte quarante minutes à un agent pour la redécouvrir.
entities/payment-gateway.md est un chemin, pas un score de similarité. Deux sessions qui interrogent la passerelle lisent la même page.Pour une codebase, gardez le wiki dans le dépôt (par exemple .wiki/) pour qu’il soit versionné avec le code, et intégrez un protocole de session au schéma :
## protocole de session (CLAUDE.md)
début :
  - lire .wiki/index.md, puis .wiki/entities/<module>.md pour chaque module de la tâche
  - lire .wiki/playbooks/<type-de-tâche>.md s'il existe
fin :
  - mettre à jour les pages d'entité des modules modifiés : nouveaux invariants, comportements supprimés
  - ajouter les impasses dans playbooks/<type-de-tâche>.md sous "## essayé sans succès"
  - citer les commits en [src:git:<sha>] et les PR en [src:pr:<id>]
  - ajouter une entrée à log.md : `## [date] session | <ticket> | pages: ...`
L’effet est cumulatif. La session un découvre que le wrapper de retry avale les clés d’idempotence et l’écrit. La session neuf, exécutée par un autre agent sur un autre ticket, le lit dans la page du module avant de toucher au code. Citer les SHA de commit comme sources donne aussi un signal d’obsolescence au lint : une page qui cite du code réécrit depuis devient candidate à la revue.
Quand plusieurs agents partagent un wiki, il devient un tableau noir, et les tableaux noirs se dégradent le plus vite sous les écritures concurrentes. Deux règles le gardent sain :
syntheses/ et sources/ ; un agent de code n’écrit que dans les pages d’entité des modules qu’il a touchés. Encodez ces périmètres dans le schéma et faites-les respecter par le validateur.Un wiki que seul un agent sur un seul laptop peut lire reste un outil personnel. Envelopper le répertoire du wiki dans un serveur MCP en fait une infrastructure partagée : n’importe quel client compatible MCP (un agent dans l’IDE, un bot Slack, un job CI, un assistant d’incident) peut naviguer dans la connaissance compilée avec les mêmes primitives que l’agent mainteneur.
Exposez le modèle de navigation, pas un système de fichiers générique. Des resources pour les lectures stables, des tools pour la navigation, et un seul chemin d’écriture qui ne touche jamais directement le disque.
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("llm-wiki")

@mcp.resource("wiki://index")
def index() -> str:
    """Le catalogue. Les clients doivent le lire avant tout le reste."""
    return INDEX.read_text()

@mcp.resource("wiki://page/{slug}")
def page(slug: str) -> str:
    return read_page_scoped(slug, caller_scopes())     # ACL par répertoire

@mcp.tool()
def search(query: str, limit: int = 10) -> list[dict]:
    """BM25 sur titres, alias, résumés et intertitres. Renvoie slug + résumé d'une ligne."""
    return bm25.search(query, limit)

@mcp.tool()
def neighbors(slug: str, depth: int = 1) -> dict:
    """Liens [[...]] entrants et sortants autour d'une page, avec résumés d'une ligne."""
    return link_graph().ego(slug, depth)

@mcp.tool()
def history(slug: str, limit: int = 5) -> list[dict]:
    """Commits récents touchant la page : date, hash de la source, résumé."""
    return git_log_for(WIKI / f"{slug}.md", limit)

@mcp.tool()
def propose_edit(slug: str, patch: str, source_ref: str, rationale: str) -> str:
    """Place un diff unifié dans la file du curateur. N'écrit jamais directement dans le wiki."""
    return review_queue.put(slug, patch, source_ref, rationale, caller())
Notez ce qui manque : pas de write_page, pas de delete. Les clients externes ont un accès large en lecture et un accès en écriture uniquement via une file de revue, qui alimente le même validateur et le même curateur que l’ingestion interne.
Pipelines CI. À chaque PR fusionnée, un job écrit la description de la PR, le ticket lié et un résumé du diff dans raw/prs/<id>.md, puis déclenche l’ingestion. Les pages d’entité des modules touchés sont à jour quelques minutes après le merge. Le sens inverse est tout aussi utile : une vérification de PR appelle neighbors sur les modules touchés par le diff et commente avec les ADR pertinents et les pièges connus avant le début de la revue.
Bots Slack. Le bot est un client MCP avec des droits de lecture. Il répond à partir des pages du wiki et les met en lien, donc chaque réponse est à un clic de ses citations. Quand un humain le corrige dans un fil, le bot appelle propose_edit avec le lien du message comme source_ref, et la correction entre dans la file de revue au lieu de s’évaporer dans l’historique du chat.
Observabilité et outillage d’incident. Quand une alerte se déclenche, l’assistant d’incident lit la page d’entité du service en alerte : responsables, dépendances amont, modes de défaillance connus, les trois derniers incidents. Après résolution, le postmortem arrive dans raw/postmortems/ et est ingéré, ce qui met à jour la même page d’entité. La boucle se referme : chaque incident accélère le triage du suivant.
wiki/finance/, wiki/hr/) et appliquez-les dans le serveur, pas dans le prompt. L’index servi à un appelant ne doit lister que les pages qu’il a le droit de lire.log.md répond à « quelles questions ont lu cette page ». Gardez les deux ; les régulateurs et les équipes sécurité demanderont chacun.Une équipe sous Copilot Business dispose déjà de toutes les primitives dont le pattern a besoin, sous d’autres noms. Les fichiers d’instructions portent le schéma, les custom agents portent les rôles, les prompt files portent les trois opérations, MCP expose le wiki, et Copilot CLI exécute le travail par lots et planifié qu’une session d’IDE ne devrait pas porter. Cette section est un blueprint complet de dépôt pour le mode agent de VS Code et Copilot CLI, avec MCP activé au niveau de l’organisation.
| Concept LLM Wiki | Artefact Copilot Business | Emplacement |
|---|---|---|
| Schéma | Instructions de dépôt et par chemin | .github/copilot-instructions.md, .github/instructions/*.instructions.md |
| Rôle de mainteneur | Custom agent avec outils d’écriture | .github/agents/wiki-curator.agent.md |
| Rôle de lecteur | Custom agent, outils en lecture seule | .github/agents/wiki-reader.agent.md |
| Ingest, query, lint | Prompt files invoqués en commandes slash | .github/prompts/*.prompt.md |
| Surface de lecture partagée | Serveur MCP déclaré par workspace | .vscode/mcp.json, ~/.copilot/mcp-config.json |
| Ingestion par lots, lint nocturne | Copilot CLI en mode programmatique | scripts et GitHub Actions |
| Validateur | Script déterministe, pre-commit et CI | tools/wiki_check.py |
Utilisez les deux, pour des types de connaissance différents. Un .wiki/ dans le dépôt contient la mémoire de module qui doit être versionnée avec le code : invariants, pièges, notes procédurales issues des sessions d’agent. Un dépôt de connaissance central contient la connaissance d’organisation qui traverse les dépôts : architecture, services de plateforme, ADR, postmortems, documentation fournisseurs.
payments-service/                     # n'importe quel dépôt de code
├── AGENTS.md                         # court pointeur vers le schéma du wiki
├── .wiki/
│   ├── SCHEMA.md                     # couche 3, règles locales au dépôt
│   ├── index.md  log.md
│   ├── entities/  playbooks/  syntheses/
│   └── raw/                          # digests de PR, notes de session (ajout seul)
├── .github/
│   ├── copilot-instructions.md
│   ├── instructions/wiki.instructions.md
│   ├── agents/wiki-curator.agent.md  wiki-reader.agent.md
│   ├── prompts/wiki-ingest.prompt.md  wiki-query.prompt.md
│   │          wiki-lint.prompt.md    wiki-session-end.prompt.md
│   └── workflows/wiki-check.yml
├── .vscode/mcp.json
└── tools/wiki_check.py

kb-central/                           # un dépôt de connaissance pour toute l'organisation
├── SCHEMA.md
├── raw/      architecture/ adrs/ postmortems/ vendors/
├── wiki/     index.md log.md entities/ concepts/ sources/ syntheses/
├── mcp/      server.py               # le serveur de la section MCP
├── scripts/  ingest_batch.sh
└── .github/  agents/ prompts/ workflows/wiki-nightly.yml
La règle qui les empêche de diverger : les dépôts de code lisent le wiki central via MCP et n’y écrivent jamais. Tout ce qu’un dépôt apprend et qui relève du niveau central passe par propose_edit, et le curateur central le fusionne.
Ce sont des réglages de politiques dans les paramètres Copilot de l’organisation, faits une seule fois par un propriétaire de l’organisation :
llm-wiki pour que les développeurs ne puissent pas brancher Copilot sur des serveurs arbitraires.raw/ ni le wiki, sinon l’agent compilera à partir de rien.Copilot applique .github/copilot-instructions.md à chaque chat du dépôt. Gardez-le court et faites-le pointer vers le schéma, pour que les règles complètes du wiki ne se chargent que lorsque des fichiers du wiki sont en jeu.
<!-- .github/copilot-instructions.md -->
Ce dépôt contient une base de connaissance maintenue par un agent dans `.wiki/`.
- Avant de modifier le code d'un module, lire `.wiki/index.md` et la page du module dans `.wiki/entities/`.
- La connaissance de l'organisation (architecture, services de plateforme, ADR) est dans le serveur MCP `llm-wiki`. La lire ; ne jamais tenter d'y écrire.
- Ne jamais modifier les fichiers sous `.wiki/raw/`. Ne jamais modifier les pages de `.wiki/` sauf en tant qu'agent wiki-curator.
Le schéma complet est porté par un fichier d’instructions par chemin, appliqué seulement quand l’agent touche au wiki :
---
applyTo: ".wiki/**"
---
# schéma du wiki (local au dépôt)

## invariants
- `.wiki/raw/` est en ajout seul. Ne jamais modifier ni supprimer un fichier qui s'y trouve.
- Chaque phrase factuelle se termine par une balise de source : [src:<hash>], [src:git:<sha>] ou [src:pr:<numéro>].
- Ne jamais résoudre une contradiction en silence. L'enregistrer sous `## conflits` avec les deux sources.
- Ne jamais supprimer une page. Mettre `status: retired` dans son frontmatter.

## modèles de pages
- entities/<module>.md : rôle, responsables, invariants, dépendances, pièges connus, conflits, liens.
- playbooks/<tâche>.md : étapes qui fonctionnent, `## essayé sans succès` avec la raison, dernier commit vérifié.

## après chaque écriture
Exécuter `python tools/wiki_check.py --staged` et corriger toutes les erreurs avant de terminer.
L’appel à wiki_check.py est la ligne importante. On ne peut pas faire confiance à Copilot pour s’auto-discipliner sur les invariants, donc le schéma délègue le contrôle au validateur déterministe de la section lint et demande à l’agent de traiter ses erreurs comme bloquantes.
Le curateur écrit ; le lecteur ne le peut pas. Les listes d’outils du frontmatter imposent cette séparation, et llm-wiki/* donne accès à tous les outils du serveur MCP.
---
name: wiki-curator
description: Maintient la base de connaissance dans .wiki/. Ingère les sources, met à jour les pages, lance les vérifications. Ne modifie jamais le code applicatif.
tools: ['read', 'search', 'edit', 'execute', 'llm-wiki/*']
handoffs:
  - label: Lancer le lint sur ce que je viens de modifier
    agent: wiki-curator
    prompt: /wiki-lint scope=staged
---
Tu es le curateur du wiki. Suis exactement le schéma de `.github/instructions/wiki.instructions.md`.

Pour chaque tâche :
1. Lis `.wiki/index.md` d'abord. Planifie les pages concernées avant de les ouvrir.
2. Ne modifie que des fichiers sous `.wiki/` (jamais `.wiki/raw/`).
3. Exécute `python tools/wiki_check.py --staged`. Corrige toutes les erreurs.
4. Ajoute une entrée à `.wiki/log.md`.
5. Résume : pages créées, pages mises à jour, conflits ouverts.
Si un fait relève de la connaissance d'organisation, appelle `llm-wiki/propose_edit` au lieu de l'écrire ici.
---
name: wiki-reader
description: Répond aux questions à partir du wiki du dépôt et du wiki de l'organisation. Lecture seule. Cite les pages.
tools: ['read', 'search', 'llm-wiki/*']
---
Réponds à partir de la connaissance compilée, pas des sources brutes ni de suppositions.
1. Lis `.wiki/index.md` ; pour les sujets d'organisation, lis la resource `wiki://index` de llm-wiki.
2. Ouvre 8 pages au maximum ; suis les [[liens]] sur un saut si la réponse l'exige.
3. Cite chaque affirmation en [[page]]. Si le wiki ne couvre pas le sujet, dis-le et nomme la page manquante.
N'appelle jamais `propose_edit` ; suggère plutôt à l'utilisateur de lancer /wiki-ingest.Le lecteur liste quand même llm-wiki/*, donc sa garantie de lecture seule sur la connaissance d’organisation vient du serveur, qui n’expose aucun outil d’écriture en dehors de la file de revue. C’est le bon endroit pour l’imposer.
Chaque opération devient une commande slash liée au bon agent. Les développeurs tapent /wiki-ingest, /wiki-query, /wiki-lint ou /wiki-session-end dans le chat de VS Code.
---
description: Ingérer une source dans le wiki du dépôt
agent: wiki-curator
---
Ingère ${input:source:chemin sous .wiki/raw/ ou numéro de PR}.

1. Si c'est un numéro de PR, écris `.wiki/raw/prs/<numéro>.md` avec le titre, la description, le ticket lié et
   un résumé du diff fichier par fichier. C'est le seul cas où tu crées un fichier sous raw/.
2. Calcule son hash court et ajoute-le à `.wiki/raw/manifest.jsonl`.
3. Planifie : liste les entités et concepts touchés, associés à des pages existantes ou NEW. Montre le plan.
4. Écris `sources/<hash>.md`, puis mets à jour ou crée chaque page du plan. Compte 5 à 15 pages.
5. Toute affirmation existante contredite par la source va sous `## conflits`. Ne modifie pas l'ancienne affirmation.
6. Mets à jour index.md, lance le validateur, ajoute une entrée à log.md.
---
description: Consigner dans le wiki du module ce que cette session a appris
agent: wiki-curator
---
Passe en revue les changements de cette session (`git diff` par rapport au commit de départ) et le chat jusqu'ici.
Pour chaque module touché :
- Mets à jour sa page d'entité avec les invariants nouveaux ou modifiés, en citant les commits en [src:git:<sha>].
- Ajoute ce qui a échoué, et pourquoi, sous `## essayé sans succès` dans le playbook concerné.
N'écris rien qui ne soit pas étayé par le diff ou par la sortie d'une commande de cette session.Le prompt de fin de session est ce qui transforme le mode agent de VS Code en mémoire de long terme. Faites-en une habitude d’équipe, comme on écrit un message de commit : on termine la tâche, on lance /wiki-session-end, on relit le diff, on commite le code et le wiki ensemble.
Commitez .vscode/mcp.json pour que chaque développeur dispose des mêmes serveurs. Le serveur local sert le wiki du dépôt ; le serveur central sert kb-central depuis un hôte interne.
{
  "servers": {
    "llm-wiki": {
      "type": "http",
      "url": "https://kb.internal.example.com/mcp"
    },
    "repo-wiki": {
      "type": "stdio",
      "command": "python",
      "args": ["-m", "wiki_mcp", "--root", "${workspaceFolder}/.wiki", "--read-only"]
    }
  }
}
Faites tourner le serveur central derrière votre proxy SSO et déduisez les périmètres de répertoires de l’appelant à partir de son identité authentifiée, comme décrit dans la section MCP. Le serveur du dépôt est volontairement en lecture seule : dans le dépôt, l’agent curateur modifie directement les fichiers et le validateur les contrôle ; MCP sert à la navigation (search, neighbors, history), plus rapide et moins coûteuse que de laisser l’agent faire des grep dans le markdown.
L’ingestion interactive convient pour une PR. Rattraper quarante ADR ou un trimestre de postmortems relève d’un script. Le mode programmatique de Copilot CLI (copilot -p) exécute une tâche headless par source avec une allowlist d’outils explicite, et --agent réutilise la même définition de curateur.
#!/usr/bin/env bash
# kb-central/scripts/ingest_batch.sh : une source par exécution headless, un commit par source
set -euo pipefail

for src in "$@"; do
  copilot -p "Ingère ${src} en suivant SCHEMA.md. Puis lance le validateur et ajoute une entrée à wiki/log.md." \
    --agent wiki-curator \
    --allow-tool 'write' \
    --allow-tool 'shell(python tools/wiki_check.py:*)' \
    --allow-tool 'shell(git add:*)' \
    --deny-tool 'shell(git push)' \
    --deny-tool 'shell(rm:*)'

  python tools/wiki_check.py --staged          # faire confiance, mais vérifier hors de l'agent
  git commit -m "ingest $(basename "$src")" -- wiki/ raw/manifest.jsonl
done
Trois détails comptent. Une source par invocation garde le contexte de chaque exécution réduit et chaque commit réversible. Les règles deny l’emportent sur les règles allow, donc l’agent ne peut ni pousser ni supprimer, même si un prompt caché dans une source le lui demande. Et le script relance lui-même le validateur au lieu de croire l’agent sur parole.
Pour l’accès MCP de la CLI elle-même, déclarez le serveur central dans ~/.copilot/mcp-config.json (ou de manière interactive avec /mcp add), pour que les exécutions par lots puissent appeler search et neighbors afin de trouver les pages à mettre à jour au lieu de parcourir tout l’index.
Deux workflows referment la boucle. La vérification s’exécute sur chaque PR de chaque dépôt et n’a besoin d’aucun modèle :
# .github/workflows/wiki-check.yml
name: wiki-check
on: pull_request
jobs:
  check:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - name: les sources brutes sont en ajout seul
        run: |
          if git diff --name-only --diff-filter=MDR origin/${{ github.base_ref }}... -- .wiki/raw/ | grep .; then
            echo "::error::des fichiers sous .wiki/raw/ ont été modifiés ou supprimés"; exit 1
          fi
      - name: lint structurel
        run: python tools/wiki_check.py --all --fail-on orphans,broken,unindexed,uncited
Le lint sémantique tourne chaque nuit dans kb-central via Copilot CLI et ouvre une pull request au lieu de commiter sur main, pour qu’un humain relise chaque conflit remonté par le modèle :
# kb-central/.github/workflows/wiki-nightly.yml
name: wiki-nightly-lint
on:
  schedule: [{ cron: "0 2 * * 1-5" }]
jobs:
  lint:
    runs-on: ubuntu-latest
    permissions: { contents: write, pull-requests: write }
    steps:
      - uses: actions/checkout@v4
      - run: npm install -g @github/copilot
      - name: lint sémantique (échantillonné)
        env:
          # jeton du siège de service curateur ; voir la doc Copilot CLI de GitHub pour la permission requise
          COPILOT_GITHUB_TOKEN: ${{ secrets.WIKI_CURATOR_TOKEN }}
        run: |
          git switch -c lint/$(date +%F)
          copilot -p "/wiki-lint scope=sample size=50" --agent wiki-curator \
            --allow-tool 'write' --allow-tool 'shell(python tools/wiki_check.py:*)' \
            --deny-tool 'shell(git push)'
      - name: ouvrir la PR
        run: |
          git add wiki/ && git commit -m "nightly lint $(date +%F)" || exit 0
          git push -u origin HEAD && gh pr create --fill --label wiki-lint
        env: { GH_TOKEN: ${{ github.token }} }
Le push et la PR se font dans une étape séparée avec le jeton du workflow, en dehors des permissions de l’agent. L’agent propose ; le pipeline et un relecteur décident.
Commencez par un dépôt et un curateur, pas par toute l’organisation :
kb-central, schéma v1, ingestion manuelle de 10 à 20 sources à forte valeur avec /wiki-ingest, en lisant chaque diff.wiki_check.py et le workflow de PR, activer /wiki-session-end dans le dépôt pilote..wiki/ et les fichiers .github/ partagés issus d’un dépôt template.Quelques contraintes propres à Copilot façonnent la conception :
edit peut techniquement écrire n’importe où dans le workspace. Les instructions disent « jamais raw/ », mais la garantie vient de la vérification de PR et des règles deny de la CLI, pas du prompt.Aucune des deux architectures ne domine partout. Elles placent le coût et le risque à des endroits différents, et le bon choix dépend de la taille du corpus, de son rythme de changement et du niveau de synthèse qu’exigent vos questions.
| Dimension | RAG traditionnel | LLM Wiki |
|---|---|---|
| Efficacité en tokens | Peu coûteux par requête (top-k chunks, quelques milliers de tokens) mais redondant : fragments qui se recouvrent, et les questions transverses exigent un k élevé ou échouent. L’ingestion ne coûte que l’embedding. | Ingestion coûteuse (une source réécrit 10 à 15 pages). Les requêtes lisent l’index plus quelques pages : plus de tokens qu’un top-k, mais bien plus denses, et amortis sur toutes les questions suivantes. |
| Qualité de synthèse | Bornée par k et par le découpage. Contradictions résolues en silence, de façon incohérente d’une requête à l’autre. Aucune mémoire des réponses précédentes. | Synthèse faite une fois, avec toutes les pages concernées sous les yeux. Conflits explicites et sourcés. Les bonnes réponses sont reclassées et réutilisées. |
| Échelle et infrastructure | Passe à l’échelle de façon prévisible jusqu’à des millions de documents ; la récupération est un problème de recherche. Exige un vector store, un pipeline d’embedding, souvent un reranker. | Un dossier de markdown et git. La navigation par index se dégrade quand le catalogue grossit ; les grands wikis ont besoin d’index hiérarchiques, puis de recherche, puis d’embeddings sur le wiki lui-même. |
| Maintenance et gouvernance | Entretien quasi nul une fois l’indexation en place, mais aucun artefact à relire : les erreurs n’apparaissent que sous forme de mauvaises réponses. Fraîcheur immédiate. | Exige du lint, un triage des conflits et des audits périodiques. En échange, chaque changement est un diff relisible et réversible, avec attribution de source. La fraîcheur suit avec retard, jusqu’à la ré-ingestion. |
Le pattern est à son meilleur tant que l’agent peut naviguer en lisant. En pratique, cela tient tant que le wiki compilé reste autour de 50k à 100k tokens de résumés et d’index, l’ordre de grandeur du propre dispositif de Karpathy : une centaine de sources et quelques centaines de pages. Dans cette enveloppe, l’agent lit index.md en une passe, choisit ses pages avec précision, et charge souvent l’essentiel de ce qui compte dans son contexte. Aucune infrastructure de récupération n’est nécessaire.
Au-delà, trois choses arrivent ensemble : l’index ne tient plus confortablement à côté des pages qu’il référence, la sélection de pages dans un long catalogue devient moins fiable, et les plans d’ingestion ratent des pages qu’ils auraient dû mettre à jour, ce qui fait revenir les doublons. L’escalade classique :
index.md pointe vers des index par catégorie, et l’agent descend un niveau à la fois.Pour des corpus d’entreprise de plusieurs millions de documents, n’essayez pas de tout compiler. Compilez la tranche à forte valeur et forte réutilisation (architecture, produits, politiques, incidents récurrents) dans le wiki, et gardez un RAG sur le stockage brut pour la longue traîne et pour tout ce qui change plus vite que vous ne ré-ingérez. Les deux couches se complètent : le wiki répond à « que savons-nous », le RAG répond à « que dit le document X en ce moment ».
La dérive est le mode de défaillance propre à cette architecture. Chaque ingestion est une occasion de petites erreurs : un qualificatif perdu, un chiffre arrondi, deux entités fusionnées à tort. Chaque modification s’appuie sur le texte précédent, donc les erreurs se cumulent comme au jeu du téléphone, et après quelques centaines d’ingestions une page exacte au départ peut devenir fausse avec aplomb. Les contrôles qui fonctionnent :
log.md), reconstruisez chacune à partir de ses sources brutes citées dans un contexte neuf, et comparez les affirmations avec la page en ligne. Toute divergence ouvre un conflit. Voyez-le comme un test de propriétés appliqué à la connaissance.revisions d’une page dépasse une limite (10 à 15 est un bon point de départ), régénérez-la à partir de ses sources au lieu de modifier la dernière modification. Cela casse la chaîne du jeu du téléphone.Le LLM Wiki parie que le travail de connaissance devrait ressembler davantage au génie logiciel : un arbre de sources, un compilateur, un artefact de build, des tests, de la revue, du contrôle de version. Ce cadrage est aussi sa limite honnête. Il hérite des coûts d’un système de build en même temps que de ses bénéfices, et les équipes qui font l’impasse sur le validateur, les niveaux de lint et les audits de dérive finiront avec un wiki fluide, bien lié, et lentement faux. Celles qui gardent la discipline obtiennent ce que le RAG n’a jamais offert : une base de connaissance qui s’améliore à chaque source, un diff relisible à la fois.
Références pour la mise en œuvre Copilot :
